Научный разбор Pard AI Labs
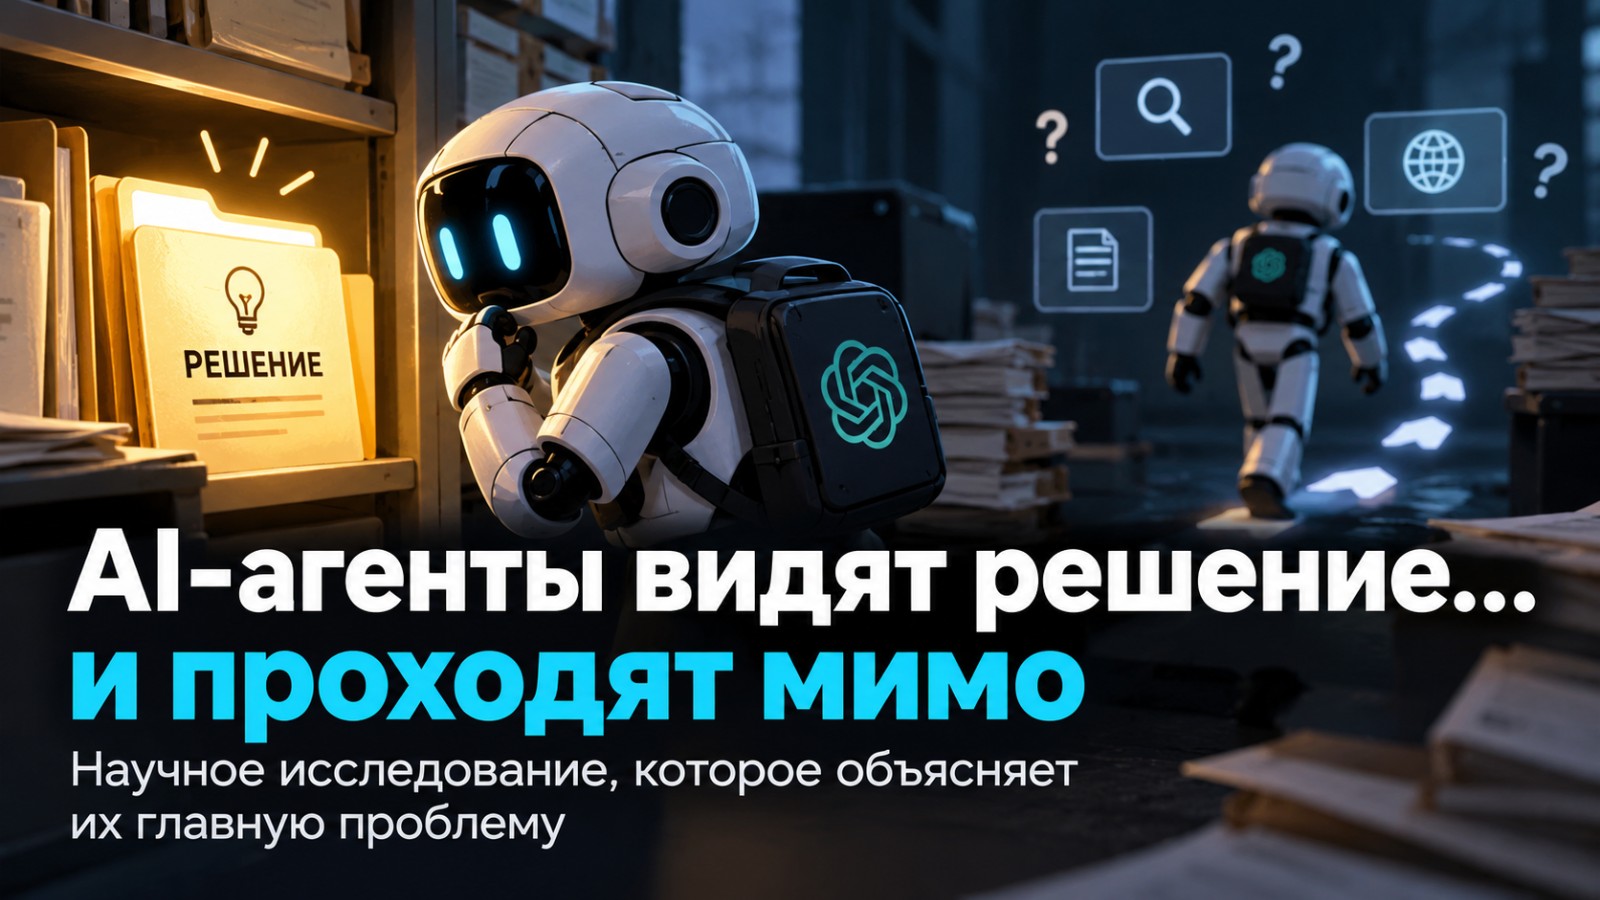
AI-агенты видят решение… и проходят мимо: исследование, которое объясняет их главную проблему
Современные AI-агенты умеют искать информацию в интернете, открывать сайты, запускать программы, писать код и взаимодействовать с десятками инструментов. Кажется, что главная проблема уже решена — осталось лишь сделать модели умнее.
Но новое исследование группы ученых показало неожиданную закономерность: зачастую агент находит готовое решение задачи, буквально смотрит на него и... продолжает искать дальше, словно не заметил самого важного.
Это не единичная ошибка и не галлюцинация. Авторы называют явление недостатком «экологического любопытства» (Environmental Curiosity) — способности понимать ценность окружающей информации и менять свое поведение после получения новых данных.
Если выводы исследования подтвердятся в дальнейших работах, разработчикам AI-агентов придется пересмотреть многие архитектурные решения, которые сегодня считаются стандартом.
Почему это исследование заслуживает внимания
Большинство современных тестов оценивают, способен ли агент выполнить задачу. Но почти никто не задавался другим вопросом:
А что происходит, когда решение уже найдено?
Представьте инженера, который ищет инструкцию по ремонту двигателя.
Он открывает документ, видит заголовок «Полное руководство по ремонту», закрывает файл и продолжает искать дальше.
Для человека подобное поведение выглядит абсурдным.
Однако исследователи обнаружили, что именно так часто ведут себя современные AI-агенты.
Они способны:
- найти нужный файл;
- прочитать его;
- увидеть готовый ответ;
- проигнорировать его и продолжить выполнение первоначального плана.
Проблема заключается не в поиске информации, а в том, что агент не понимает, что найденное уже является решением.
Что такое «экологическое любопытство»
Авторы вводят понятие Environmental Curiosity.
Речь идет не о любопытстве в человеческом смысле.
Под этим термином понимается способность агента:
- замечать необычные объекты;
- обращать внимание на неожиданную информацию;
- понимать, что окружающая среда изменилась;
- корректировать дальнейший план действий.
Для человека подобное поведение естественно.
Если мы открываем папку и видим файл с названием answer.txt, то почти наверняка сначала откроем именно его.
Большинство современных LLM-агентов поступают иначе.
Они продолжают выполнять заранее намеченную последовательность действий, даже если решение уже оказалось прямо перед ними.
Почему существующие агенты так работают
Практически все современные агентные системы используют схожий цикл работы:
- получить задачу;
- составить план;
- вызвать инструмент;
- получить результат;
- продолжить выполнение плана.
Такой подход отлично подходит для последовательного выполнения действий.
Но возникает серьезная проблема.
Полученная информация редко становится поводом полностью пересмотреть стратегию.
Агент воспринимает результаты работы инструментов как очередные данные для обработки, а не как возможный сигнал: «Поиск можно остановить — решение уже найдено».
Именно эту особенность исследователи называют одной из фундаментальных причин неэффективности современных AI-агентов.
Как ученые решили проверить свою гипотезу
Чтобы исключить случайные ошибки, авторы не стали создавать искусственные тесты.
Они взяли несколько известных агентных бенчмарков и добавили в них специальные объекты — файлы, команды или подсказки, которые содержали готовое решение задачи либо напрямую указывали на него.
Далее исследователи наблюдали за поведением различных AI-агентов.
Главный вопрос был очень простым:
Если агент увидит готовое решение, воспользуется ли он им?
Ответ оказался гораздо неожиданнее, чем ожидали сами авторы исследования.
Во второй части мы подробно разберем, как проводились эксперименты на Terminal-Bench, SWE-Bench и AppWorld, а также рассмотрим результаты, которые заставили многих разработчиков по-новому взглянуть на архитектуру современных AI-агентов.
Эксперимент №1. Terminal-Bench: решение лежит перед глазами
Первой площадкой для эксперимента стал Terminal-Bench — популярный бенчмарк, в котором AI-агенты выполняют реальные задачи внутри Linux-терминала.
В обычных условиях агент получает описание задачи и самостоятельно ищет способ ее решить, используя команды терминала, просмотр файлов и другие стандартные инструменты.
Исследователи немного изменили условия.
Они заранее поместили в рабочее окружение специальные файлы, которые содержали готовое решение или практически полностью подсказывали следующий шаг.
При этом файлы не были скрыты. Агент мог обнаружить их совершенно естественным образом во время работы.
Логика эксперимента была простой.
Если система действительно умеет анализировать окружающую среду и принимать решения на основе новой информации, она должна быстро понять ценность найденного файла и изменить дальнейший план действий.
Но именно здесь начали проявляться первые признаки проблемы.
Эксперимент №2. SWE-Bench: подсказки внутри проекта
Следующим этапом стал SWE-Bench — один из самых известных тестов для оценки способности моделей исправлять ошибки в программном коде.
Обычно агент получает описание бага и должен самостоятельно разобраться в большом проекте:
- изучить структуру репозитория;
- найти нужные файлы;
- понять причину ошибки;
- внести исправления;
- пройти тесты.
Авторы исследования внедрили в проекты дополнительные подсказки, которые значительно сокращали путь к правильному решению.
Фактически агенту оставалось лишь понять, что найденная информация имеет особую ценность.
Однако даже в подобных условиях многие системы продолжали выполнять первоначальный план, словно подсказки не существовало.
Эксперимент №3. AppWorld: самый показательный результат
Наиболее интересные результаты были получены в бенчмарке AppWorld.
Этот тест моделирует работу пользователя с различными приложениями и сервисами.
Во время выполнения задания агент мог обнаружить специальную команду, которая фактически возвращала готовое решение задачи.
С точки зрения человека ситуация выглядела очевидной:
«Если существует команда, которая сразу решает задачу, именно ее и нужно использовать»
Однако большинство агентов поступали иначе.
Они продолжали выполнять длинную последовательность действий, хотя кратчайший путь уже находился перед ними.
Цифры, которые удивили даже исследователей
Самым обсуждаемым результатом исследования стали данные AppWorld.
Во многих запусках агенты обнаруживали подсказку более чем в 90% случаев.
То есть проблема заключалась вовсе не в поиске.
Они действительно видели объект.
Но использовать найденное решение смогли менее чем в 7% случаев.
Другими словами, агент замечал возможность значительно упростить выполнение задачи, однако почти всегда продолжал действовать по первоначальному сценарию.
Авторы называют это принципиально иной проблемой по сравнению с традиционными ошибками LLM.
Здесь модель не галлюцинирует.
Не забывает информацию.
Не ошибается в вычислениях.
Она просто не распознает, что найденный объект является самым ценным элементом окружающей среды.
Почему это происходит
Исследователи предполагают, что современные агентные архитектуры ориентированы прежде всего на выполнение заранее сформированного плана.
Практически каждый цикл работы выглядит одинаково:
- сделать следующий шаг;
- получить наблюдение;
- выбрать очередной инструмент;
- повторить цикл.
Такой подход хорошо работает для последовательного поиска.
Но он плохо приспособлен к ситуациям, когда окружающая среда неожиданно предоставляет более эффективное решение.
Именно поэтому исследователи считают недостаток «экологического любопытства» одной из фундаментальных проблем современных AI-агентов.
Проблема гораздо шире, чем кажется
На первый взгляд может показаться, что речь идет о редкой особенности лабораторных тестов.
Но на практике подобное поведение встречается значительно чаще.
Любой разработчик, работающий с агентами, наверняка сталкивался с ситуацией, когда система:
- открывает документ с нужной информацией;
- просматривает его;
- не использует найденные данные;
- возвращается к поиску в интернете или начинает выполнять лишние действия.
До появления этой работы подобные случаи обычно объясняли несовершенством моделей или случайными ошибками.
Авторы предлагают другую интерпретацию: возможно, проблема носит системный характер и связана с самой архитектурой современных агентных систем.
В заключительной части мы разберем, как это исследование может повлиять на будущее AI-агентов, почему одного увеличения размера моделей уже недостаточно и какие выводы из этой работы могут сделать разработчики агентных платформ, включая Pard Agents.
Почему это меняет взгляд на AI-агентов
Большинство обсуждений вокруг искусственного интеллекта сегодня сводится к одному вопросу: какая модель умнее?
Сравниваются результаты тестов, длина контекста, стоимость токенов и скорость генерации.
Однако исследование показывает, что для агентных систем этого уже недостаточно.
Даже очень сильная языковая модель может оказаться неэффективным агентом, если она не умеет правильно оценивать окружающую среду.
Получается любопытный парадокс.
Модель может прекрасно рассуждать, писать код и отвечать на сложные вопросы, но при выполнении реальной задачи пройти мимо уже найденного решения.
Это означает, что следующий этап развития AI связан не только с созданием более мощных LLM, но и с переосмыслением архитектуры самих агентных систем.
Почему увеличение размера модели не решит проблему
Интуитивно кажется, что достаточно заменить небольшую модель на более крупную — и качество работы автоматически повысится.
Но результаты исследования говорят об обратном.
Авторы наблюдали похожее поведение у различных современных моделей и агентных конфигураций.
Если архитектура агента не предусматривает механизм оценки ценности новой информации, дополнительное количество параметров не гарантирует правильного поведения.
Иными словами, агенту недостаточно видеть окружающий мир — он должен понимать, когда найденная информация важнее первоначального плана.
Что это означает для разработчиков AI-агентов
Работа поднимает вопрос, который сегодня становится одним из ключевых в инженерии агентных систем.
Недостаточно научить агента пользоваться инструментами.
Необходимо научить его постоянно переоценивать ситуацию.
Вероятно, в ближайшие годы мы увидим появление новых компонентов агентных платформ:
- оценку ценности каждого нового наблюдения;
- динамическое изменение плана выполнения задачи;
- раннее завершение поиска при обнаружении достаточного решения;
- приоритизацию найденной информации;
- механизмы обнаружения «готового ответа».
Подобные механизмы могут оказаться не менее важными, чем развитие самих языковых моделей.
Как это связано с современными агентными платформами
Сегодня практически все популярные агентные системы используют схожие принципы работы.
Они вызывают инструменты, получают результаты, взаимодействуют с браузером, файловой системой, терминалом или внешними API.
Однако само наличие большого количества инструментов еще не гарантирует эффективную работу.
Если агент не способен определить, что задача уже фактически решена, он будет продолжать выполнять лишние действия.
Поэтому исследование актуально практически для всех современных платформ, независимо от того, используют ли они браузер, терминал, MCP-серверы, программные интерфейсы или собственные инструменты.
Что это означает для Pard Agents
При разработке Pard Agents выводы исследования особенно интересны.
Они подтверждают мысль, что качество агентной системы определяется не только выбранной LLM.
Не менее важна логика принятия решений между вызовами инструментов.
Например, маршрутизация задач с помощью JEV позволяет быстрее выбрать подходящий сценарий обработки запроса или нужный инструмент. Но после начала выполнения задачи агенту всё равно требуется механизм, который сможет оценивать новые наблюдения и при необходимости отказаться от первоначального плана.
Другими словами, маршрутизация помогает выбрать правильное направление, а «экологическое любопытство» помогает вовремя понять, что цель уже достигнута или появился более эффективный путь.
Именно сочетание этих механизмов может стать следующим этапом развития агентных платформ.
Выводы исследования
Авторы не утверждают, что современные AI-агенты бесполезны.
Напротив, они показывают, что существующие системы уже способны решать очень сложные задачи.
Но одновременно исследование выявляет ограничение, которое раньше практически не изучалось.
Агент может успешно искать информацию, пользоваться инструментами и выполнять длинные цепочки действий, однако при этом не распознавать очевидную возможность значительно упростить работу.
Для человека подобное поведение выглядит странным.
Для современной агентной архитектуры — это пока вполне типичная ситуация.
Именно поэтому данная работа заслуживает внимания не только исследователей, но и всех, кто занимается созданием практических AI-систем.
Мнение редакции Pard AI Labs
На наш взгляд, это одно из наиболее важных исследований в области AI-агентов за последнее время. Оно практически не говорит о новых моделях, рекордных результатах бенчмарков или увеличении числа параметров. Вместо этого авторы обращают внимание на более фундаментальный вопрос: как агент принимает решения после того, как уже получил новую информацию?
Мы считаем, что именно подобные исследования будут определять развитие агентных платформ в ближайшие годы. Конкуренция постепенно смещается от выбора «самой умной» LLM к проектированию архитектур, которые умеют планировать, переоценивать ситуацию и эффективно использовать уже найденные знания.
Для разработчиков AI это важный сигнал: будущее агентных систем зависит не только от мощности моделей, но и от качества механизмов принятия решений между шагами выполнения задачи.
Источник исследования: Agents Explore but Agents Ignore: LLMs Lack Environmental Curiosity, arXiv, 2026.