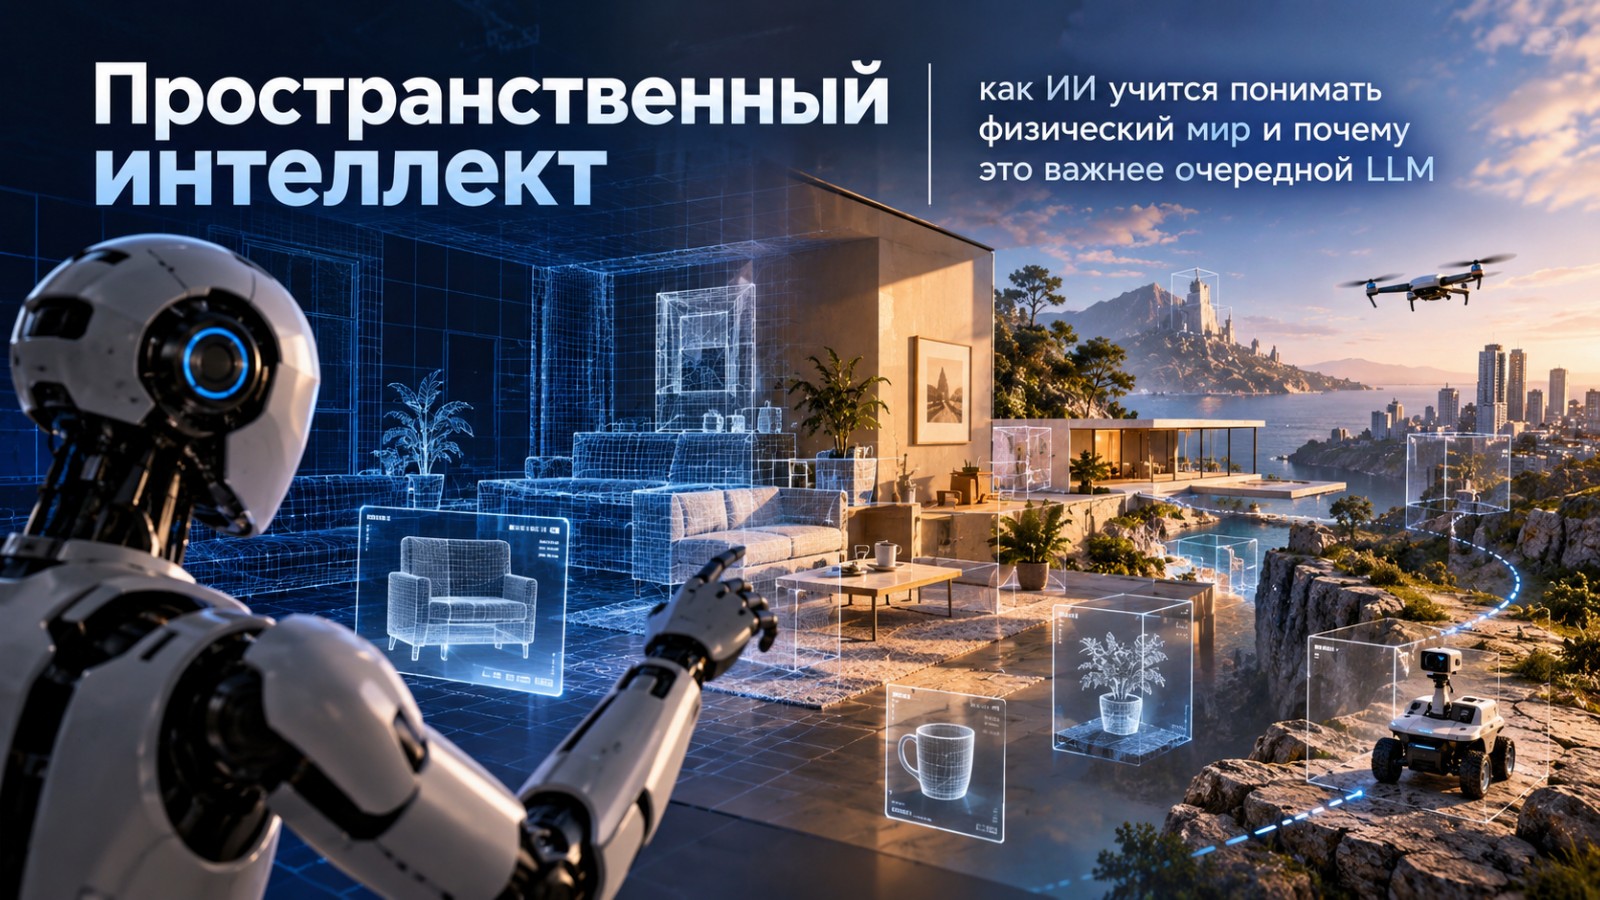
Большие языковые модели научились писать программный код, анализировать документы, решать математические задачи и поддерживать сложные диалоги. Мультимодальные системы способны распознавать объекты на фотографиях и описывать происходящее на видео. Но между умением описать окружающий мир и способностью самостоятельно действовать в нём остаётся принципиальная разница.
Представим робота, которому поручили взять со стола чашку и поставить её на полку. Ему недостаточно знать, что такое чашка. Необходимо определить её положение в трёхмерном пространстве, оценить размеры, расстояние, ориентацию ручки, возможные препятствия и доступные траектории движения. Затем нужно предсказать, что произойдёт при контакте манипулятора с предметом, и корректировать действия по мере поступления новых данных.
Именно такими задачами занимается направление Spatial AI — пространственный искусственный интеллект. С ним тесно связаны модели мира (World Models), способные представлять окружающую среду и прогнозировать её изменения.
В 2026 году это направление получило новый импульс. NVIDIA представила Cosmos 3, World Labs развивает платформу Marble, а 27 октября Google DeepMind анонсировала Genie 4 — интерактивную генеративную модель мира. Эти разработки различаются архитектурой и назначением, но отражают общий технологический сдвиг: искусственный интеллект постепенно выходит за пределы обработки информации и приближается к работе с физической средой.
Почему языковой модели недостаточно знать, что такое пространство
Современная LLM может объяснить закон всемирного тяготения, рассчитать траекторию движения и описать принцип работы промышленного манипулятора. Однако способность воспроизводить физические закономерности в тексте не означает, что модель располагает точным и непрерывно обновляемым представлением реальной сцены.
Рассмотрим простую ситуацию: на столе находятся два предмета, один частично закрывает другой. Человек понимает, что скрытый предмет продолжает существовать, даже если его не видно. Он также может предположить его форму, положение и возможное движение.
Для автономной системы такая задача требует нескольких взаимосвязанных возможностей:
- Геометрическое восприятие. Определение глубины, размеров, формы и положения объектов.
- Пространственные отношения. Понимание того, что находится впереди, позади, внутри, выше или между другими объектами.
- Постоянство объектов. Сохранение представления о предметах, временно исчезнувших из поля зрения.
- Временная динамика. Оценка скорости, направления движения и изменения состояния среды.
- Физическое прогнозирование. Предсказание последствий столкновений, перемещений и взаимодействий.
- Планирование действий. Выбор последовательности операций для достижения поставленной цели.
Отдельные элементы этих возможностей уже давно реализованы в компьютерном зрении, робототехнике и системах автоматического управления. Новизна современных исследований заключается в попытке объединить их в более универсальные обучаемые модели.
При этом пространственный интеллект не обязательно является одной большой нейросетью. Практическая система может состоять из нескольких специализированных моделей, алгоритмов локализации, геометрических представлений, планировщиков и традиционных контроллеров.
Как устроен пространственный интеллект
В отличие от текстового запроса, физическая среда представляет собой непрерывно изменяющуюся систему. Для работы с ней ИИ необходимо получать данные от сенсоров, преобразовывать их в полезное внутреннее представление, прогнозировать изменения и выбирать действия.
Упрощённо архитектуру можно представить как последовательность:
Сенсоры → восприятие → пространственная модель → прогноз → планирование → действие → обратная связь.
1. Получение данных
Источниками информации могут быть обычные камеры, стереокамеры, датчики глубины, лидары, радары, инерциальные измерительные блоки и другие сенсоры. Их выбор зависит от конкретной задачи.
Например, стереокамера позволяет оценивать глубину по различиям между двумя изображениями. Лидар непосредственно измеряет расстояния до отражающих поверхностей. Инерциальные датчики помогают отслеживать движение самого устройства.
Важная задача — объединить эти измерения, учитывая погрешности, задержки и различия между системами координат.
2. Построение представления пространства
Внутреннее представление окружающего мира может принимать разные формы:
- Облако точек (Point Cloud) — набор трёхмерных координат, описывающих поверхности.
- Воксельная сетка — разделение пространства на небольшие объёмные элементы.
- 3D-сетка (Mesh) — геометрическая модель поверхности, состоящая из вершин и полигонов.
- Occupancy Grid — карта вероятности занятости участков пространства.
- NeRF и 3D Gaussian Splatting — методы нейронного представления и визуализации трёхмерных сцен.
- Латентное представление — компактное внутреннее состояние нейросети, кодирующее существенную информацию о среде.
Эти подходы решают разные задачи. Геометрическая карта может быть удобна для расчёта безопасного маршрута, а нейронное представление — для восстановления сцены или прогнозирования её визуального состояния.
Важно понимать, что фотореалистичная трёхмерная сцена не обязательно является метрически точной. Красиво восстановленное помещение ещё не гарантирует правильного определения расстояний, физических свойств предметов и доступных траекторий.
3. Прогнозирование изменений
Следующий уровень — предсказание будущего состояния среды. Система должна оценить не только то, где находится объект сейчас, но и то, что произойдёт после определённого действия.
В общем виде модель динамики можно записать следующим образом:
s(t+1) = F(s(t), a(t), e(t))
Здесь s(t) — текущее состояние среды, a(t) — действие системы, e(t) — внешние воздействия, а F — модель перехода к следующему состоянию.
В традиционной инженерии такая функция может определяться математическими уравнениями. В обучаемых моделях мира она полностью или частично аппроксимируется нейросетью на основании данных.
Например, робот может оценивать, как изменится положение коробки после толчка. Автономный транспорт — прогнозировать перемещение других участников движения. Манипулятор — предсказывать результат захвата предмета.
Однако обучение на видео не гарантирует корректного понимания физики. Модель может хорошо воспроизводить визуальные закономерности, но ошибаться при необычных взаимодействиях или в ситуациях, которых не было в обучающей выборке.
World Models: от распознавания изображений к моделированию реальности
Термин World Model обозначает широкий класс моделей, формирующих представление о состоянии окружающей среды и, в ряде архитектур, предсказывающих её развитие.
Такие модели не обязательно создают изображения. Некоторые работают исключительно с компактными скрытыми состояниями. Другие генерируют видео, трёхмерные сцены или последовательности действий.
Поэтому следует различать три задачи:
- Понимание мира — определение объектов, их свойств, положения и взаимосвязей.
- Генерация мира — создание новых визуальных или геометрических представлений окружающей среды.
- Моделирование динамики — прогнозирование того, как состояние мира изменится со временем или после действия.
Одна система может объединять все три направления, но это не обязательное условие.
World Labs: генерация пространственно согласованных миров
Компания World Labs, среди основателей которой исследовательница искусственного интеллекта Фэй-Фэй Ли, занимается разработкой моделей пространственного интеллекта.
Её продукт Marble позволяет создавать трёхмерные миры на основе текстовых описаний, изображений, видео, панорам и 3D-структур.
Ключевое отличие от обычного генератора изображений заключается в том, что пользователь получает не единственную картинку, а пространственно согласованную среду, по которой можно перемещаться и которую можно редактировать.
Система поддерживает изменение отдельных элементов, расширение окружения, объединение сцен и экспорт результатов в различные форматы.
Для практического применения это открывает несколько направлений:
- создание виртуальных помещений и локаций;
- предварительная визуализация архитектурных и дизайнерских проектов;
- подготовка интерактивных сцен для игр и цифрового контента;
- формирование исходных пространственных материалов для инженерных экспериментов.
При этом Marble следует рассматривать прежде всего как инструмент генерации пространственных сред. Наличие устойчивой 3D-структуры само по себе не делает результат полноценным физическим симулятором, пригодным для достоверного обучения роботов.
Google DeepMind Genie 4: мир, который изменяется в ответ на действия
27 октября 2026 года Google DeepMind представила Genie 4 — новое поколение генеративных моделей мира для интерактивной симуляции в реальном времени.
Главная идея заключается в создании среды, которая не просто выглядит убедительно, но и изменяется в ответ на действия пользователя.
В демонстрациях Genie 4 можно перемещаться по сгенерированному миру, изменять окружение текстовыми командами, добавлять объекты и персонажей, менять погодные условия и наблюдать развитие событий.
Модель также генерирует звуковое сопровождение, включая окружающие шумы и интерактивные диалоги.
Особенно интересно взаимодействие Genie с моделями семейства Gemini. В описанной Google архитектуре языковая модель может интерпретировать цель, формировать последовательность действий, наблюдать результат и корректировать план, тогда как Genie отвечает за генерацию и развитие интерактивной среды.
Это демонстрирует перспективную схему объединения двух классов искусственного интеллекта:
Модель рассуждений определяет, что необходимо сделать, а модель мира прогнозирует и визуализирует, как окружающая среда может отреагировать.
Такой подход потенциально полезен для подготовки виртуальных испытаний, обучения агентов и моделирования сложных последовательностей действий.
Однако Genie 4 остаётся экспериментальной технологией. На момент анонса доступ предоставляется ограниченному кругу тестировщиков, а более широкое распространение запланировано поэтапно.
Google прямо указывает на сохраняющиеся проблемы: дрейф визуальных деталей, нарушение постоянства объектов, ошибки пространственной точности, физического взаимодействия и долгосрочной согласованности сцены.
Следовательно, реалистичность демонстраций не следует приравнивать к доказанной достоверности физических расчётов.
NVIDIA Cosmos 3: модели мира для физического ИИ
Если World Labs делает акцент на создании пространственных сред, а Genie — на интерактивной генерации, то NVIDIA Cosmos ориентирована на инфраструктуру разработки Physical AI — систем искусственного интеллекта, взаимодействующих с физическим миром.
В мае 2026 года NVIDIA представила Cosmos 3 — семейство моделей, объединяющих визуальное рассуждение, генерацию мира и прогнозирование действий.
В основе используется архитектура Mixture-of-Transformers. Согласно техническому описанию NVIDIA, она объединяет компоненты визуально-языкового анализа и генеративного моделирования, позволяя обрабатывать различные типы данных в рамках общей системы.
Cosmos 3 работает с текстом, изображениями, видео, звуком и последовательностями действий.
Семейство включает несколько вариантов:
- Cosmos 3 Super — модель на 64 миллиарда параметров, ориентированная на ресурсоёмкие задачи и высокое качество генерации.
- Cosmos 3 Nano — модель на 16 миллиардов параметров для более доступных вычислительных конфигураций и специализированной адаптации.
- Cosmos 3 Edge — компактное направление на 4 миллиарда параметров для задач с низкими задержками и вычислений ближе к устройству.
Для разработчиков робототехники особенно важна возможность создавать синтетические данные и адаптировать модели под конкретные задачи.
Например, вместо сбора огромного количества видеозаписей реального промышленного манипулятора можно формировать разнообразные виртуальные сценарии: разные положения предметов, освещение, конфигурации рабочего пространства и последовательности действий.
Полученные данные могут использоваться для обучения и тестирования систем восприятия и управления.
Но здесь возникает фундаментальная проблема, известная как sim-to-real gap — разрыв между поведением системы в симуляции и в реальной среде.
Даже качественная генеративная модель не гарантирует точного воспроизведения трения, упругости материалов, динамики контактов и характеристик сенсоров. Поэтому результаты виртуального обучения необходимо проверять в реальных условиях.
Техническая документация доступна в NVIDIA Cosmos 3 Documentation.
Как пространственный интеллект применяется в робототехнике
Практическая ценность пространственных моделей наиболее очевидна в системах, которые должны самостоятельно взаимодействовать с окружающей средой.
Промышленные роботы
Традиционный промышленный манипулятор часто работает в заранее подготовленной среде. Его движения программируются, а положение деталей фиксируется специальной оснасткой.
Пространственный интеллект позволяет создавать более гибкие системы. Робот может определять положение предметов, учитывать их ориентацию и адаптировать действия к изменениям рабочей зоны.
Например, на конвейере появляются детали с разным положением. Система компьютерного зрения определяет их геометрию, планировщик рассчитывает доступные точки захвата, а контроллер выполняет движение.
Модель мира может дополнительно прогнозировать результат операции и помогать выбирать более надёжный способ взаимодействия.
Автономная мобильная робототехника
Мобильному роботу необходимо понимать, где он находится, какие участки пространства доступны и как перемещаются окружающие объекты.
Для этого применяются SLAM, визуальная одометрия, карты занятости, обнаружение препятствий и алгоритмы планирования маршрутов.
Обучаемые пространственные модели могут дополнять эти методы семантическим пониманием сцены и прогнозированием движения объектов.
Например, робот на складе должен не только обнаружить человека перед собой, но и оценить вероятное направление его движения, чтобы безопасно скорректировать маршрут.
Беспилотные летательные аппараты
Для гражданских беспилотников пространственные модели представляют интерес в задачах автономной навигации, инспекции инфраструктуры, картографирования и обследования помещений.
Рассмотрим дрон, выполняющий осмотр промышленного здания без доступа к спутниковой навигации.
Система должна оценивать собственное положение по данным камеры и инерциальных датчиков, обнаруживать стены и перекрытия, поддерживать локальную карту пространства и выбирать безопасную траекторию.
Пространственная модель может помогать учитывать ранее наблюдавшиеся препятствия и прогнозировать изменение сцены при перемещении аппарата.
При этом задачи стабилизации, оценки состояния и управления полётом по-прежнему требуют надёжных специализированных алгоритмов. Генеративная модель мира не является заменой полётному контроллеру.
Цифровые двойники и инженерное проектирование
Ещё одно перспективное направление — соединение пространственных моделей с цифровыми двойниками.
Цифровой двойник представляет собой цифровую модель конкретного объекта или процесса, связанную с его характеристиками и, в развитых реализациях, с актуальными эксплуатационными данными.
Генеративные пространственные модели способны ускорять создание визуальных окружений, реконструкцию помещений и подготовку вариантов компоновки.
Однако для инженерного применения необходима дополнительная проверка геометрии, физических свойств и соответствия нормативным требованиям.
Генерация трёхмерной сцены и создание достоверного инженерного цифрового двойника — разные уровни сложности.
Пространственный интеллект и AI-агенты: как они будут работать вместе
Особый интерес представляет объединение пространственных моделей с агентными архитектурами.
Современный AI-агент может получать задачу, выбирать инструменты, выполнять последовательность операций и проверять результат. Однако большинство таких систем действует в цифровой среде: работает с файлами, программными интерфейсами, базами данных и веб-приложениями.
Для работы с физическим оборудованием агенту необходим дополнительный уровень — представление окружающего мира.
Рассмотрим возможную архитектуру интеллектуального мобильного робота:
- Оператор формулирует задачу естественным языком.
- Языковая модель интерпретирует цель и формирует план.
- Система восприятия собирает данные с камер и других сенсоров.
- Пространственная модель формирует представление среды.
- Модель динамики оценивает последствия возможных действий.
- Планировщик выбирает допустимую траекторию или последовательность операций.
- Низкоуровневый контроллер выполняет команды.
- Система обратной связи оценивает результат и инициирует перепланирование при необходимости.
В такой архитектуре языковая модель не должна непосредственно управлять электродвигателями на каждом цикле регулирования. Её задача — интерпретация целей и высокоуровневое планирование. Быстрые и критически важные контуры управления остаются за специализированными алгоритмами.
Для практического применения также необходимы ограничения допустимых действий, проверка команд, обработка отказов и возможность безопасного прекращения операции.
Именно взаимодействие моделей рассуждений, пространственного восприятия, прогнозирования и традиционного управления может стать основой более универсальных автономных систем.
Что пространственные модели пока не умеют
Несмотря на впечатляющие демонстрации, современные World Models находятся на этапе активных исследований. Основные ограничения носят не только вычислительный, но и фундаментальный характер.
Недостаточная физическая достоверность
Нейросеть может генерировать правдоподобное движение предметов, не воспроизводя реальные физические зависимости с требуемой точностью.
Особенно сложны взаимодействия с деформируемыми материалами, жидкостями, контактами и нестандартными объектами.
Ошибки пространственной согласованности
В длительной симуляции предметы могут изменять форму, размеры или положение. При возвращении в ранее посещённую часть сцены модель иногда восстанавливает её иначе.
Для развлекательного приложения подобная ошибка может быть незначительной. Для автономного робота, который рассчитывает траекторию на основании геометрии, она недопустима.
Ограничения долговременного прогнозирования
Чем дальше модель пытается предсказать развитие среды, тем больше неопределённость. Небольшие ошибки начального состояния могут приводить к существенным отклонениям.
Поэтому реальные автономные системы часто используют непрерывное перепланирование с учётом новых измерений, а не полагаются на единственный долгосрочный прогноз.
Высокие вычислительные требования
Обработка нескольких видеопотоков, поддержание пространственного состояния и генерация будущих сценариев требуют значительных вычислительных ресурсов.
Для мобильных роботов и небольших автономных устройств важны энергопотребление, задержка обработки и устойчивость работы без облачного подключения.
Компактные модели и специализированные ускорители могут снизить эти ограничения, но пока нельзя считать, что универсальная модель мира способна эффективно работать на любом устройстве.
Недостаточная проверяемость результатов
Красивые видеодемонстрации не заменяют независимых испытаний. Для инженерной оценки необходимы измеримые показатели: точность восстановления геометрии, ошибка прогноза движения, устойчивость к изменениям освещения, задержка обработки, частота отказов и успешность выполнения реальных задач.
Особенно важно проверять модели на данных, отличающихся от обучающей выборки.
Заменят ли пространственные модели большие языковые модели?
Вероятнее всего, речь идёт не о замене, а о специализации и объединении различных типов искусственного интеллекта.
Языковые модели эффективны в работе с символической информацией, документацией, программным кодом и высокоуровневыми задачами. Пространственные модели ориентированы на геометрию, взаимное положение объектов и представление физической среды. Модели динамики позволяют оценивать возможные последствия действий.
Эти способности дополняют друг друга.
В перспективной инженерной системе LLM может выступать интеллектуальным интерфейсом и планировщиком, пространственная модель — обеспечивать представление среды, а специализированные алгоритмы — выполнять расчёты и управление.
При этом нет оснований утверждать, что развитие пространственного интеллекта автоматически сделает языковые модели второстепенными. Разные задачи требуют разных представлений данных и разных механизмов вычисления.
Что это означает для разработчиков
Главный практический вывод заключается в том, что пространственный интеллект уже можно изучать и применять поэтапно, не дожидаясь появления универсального искусственного интеллекта.
Разработчику робототехнической системы полезно начинать не с самой большой генеративной модели, а с конкретной задачи: определения глубины, восстановления геометрии, локализации, прогнозирования движения или планирования действий.
Для первых экспериментов доступны традиционные инструменты компьютерного зрения, SLAM, библиотеки трёхмерной обработки данных и физические симуляторы. Современные World Models можно использовать как дополнительный компонент — например, для генерации сценариев, анализа сцен или исследований обучаемой динамики.
При выборе технологии необходимо ответить на несколько вопросов: требуется ли метрическая точность, насколько критична задержка, какие сенсоры доступны, можно ли использовать облачные вычисления и как будет проверяться результат в реальном мире.
Это позволяет избежать распространённой ошибки: внедрения сложной генеративной модели туда, где надёжнее и дешевле работает традиционный алгоритм.
Заключение
Пространственный интеллект расширяет возможности искусственного интеллекта от анализа информации к пониманию структуры окружающей среды и прогнозированию её изменений.
World Labs демонстрирует развитие генеративных трёхмерных представлений. Google DeepMind исследует интерактивные модели мира, способные реагировать на действия. NVIDIA развивает инструменты для создания и обучения систем физического ИИ.
Но между убедительной виртуальной сценой и автономной машиной, надёжно работающей в реальности, всё ещё существует значительная дистанция.
Для её преодоления нужны точные измерения, качественные модели динамики, специализированные алгоритмы управления и систематические испытания.
Главное изменение заключается не в том, что ИИ научился создавать трёхмерные изображения. Гораздо важнее появление систем, которые постепенно учатся связывать восприятие пространства, прогнозирование последствий и реальные действия.
Именно в этом направлении пространственный интеллект может оказать наиболее заметное влияние на робототехнику, промышленную автоматизацию и инженерные системы следующего поколения.
Источники и материалы для изучения
- Google DeepMind — Genie 4: A New Generation of World Simulation. Официальное описание модели, демонстрации и ограничения.
- World Labs — Spatial Intelligence. Исследовательское направление и описание пространственных моделей.
- World Labs — Marble. Платформа генерации интерактивных трёхмерных миров.
- NVIDIA — Cosmos. Семейство моделей для физического искусственного интеллекта.
- NVIDIA — Cosmos 3 Documentation. Техническая документация и материалы для разработчиков.
- Google DeepMind — Gemini Robotics-ER 1.6. Пространственные рассуждения и применение ИИ в робототехнике.