AI-агенты: когда они нужны, а когда достаточно одного запроса
Агент имеет смысл, если задаче нужны несколько шагов и инструменты. Для одного абзаца это лишняя сложность и лишние ошибки.
AI-агенты · Программирование
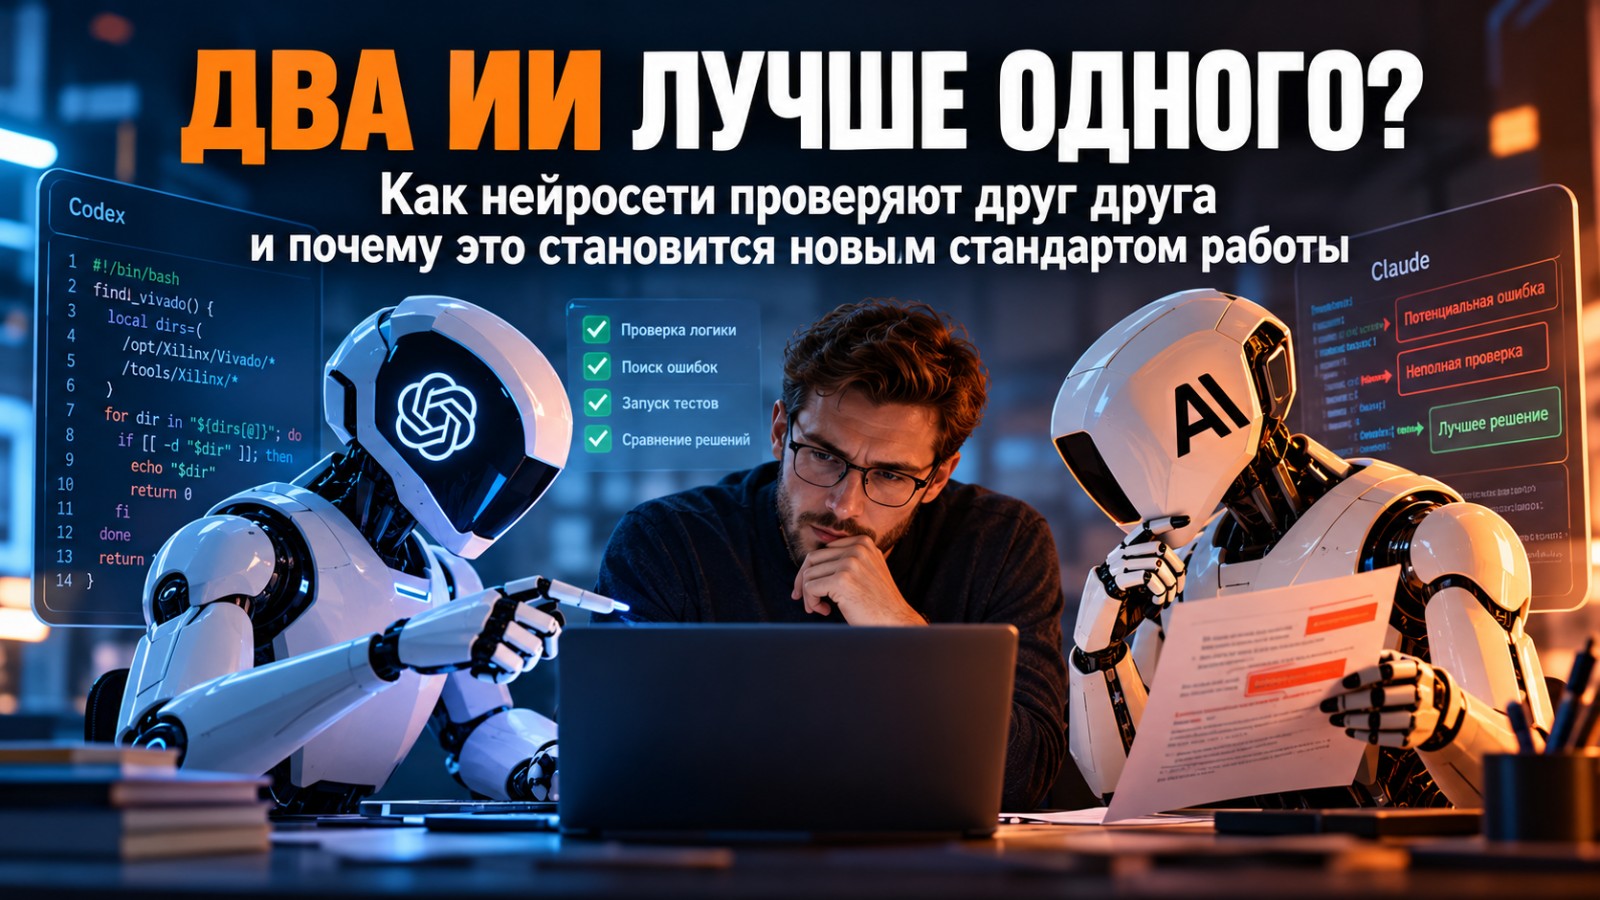
Одной нейросети уже недостаточно для сложных задач. Всё чаще один ИИ создаёт результат, второй ищет ошибки, а человек принимает окончательное решение. Разбираем эксперимент Юрия Панчула, результаты научных исследований и реальные кейсы компаний, чтобы понять, когда такая схема действительно повышает качество, а когда только увеличивает расходы. Статья о том, почему будущее искусственного интеллекта — не в отдельных моделях, а в правильно построенных агентных системах
Когда ChatGPT, Claude, Gemini или другая современная модель отвечает на вопрос, она почти никогда не сообщает: «Я не уверен». Правильные и ошибочные ответы звучат одинаково убедительно. Поэтому человек часто замечает ошибку уже после того, как решение принято, код отправлен в репозиторий или документ подписан.
Логичный вопрос звучит просто: если одному ИИ нельзя полностью доверять, может быть, стоит подключить второго? Один создаёт результат, второй независимо его проверяет. А если они не согласны — искать причину расхождения.
Идея кажется очевидной, но действительно ли она работает? Ответ оказался гораздо интереснее, чем простое «да» или «нет».
3 октября инженер и проектировщик процессоров Юрий Панчул решил проверить эту идею на практике. Он дал одну и ту же задачу двум независимым ИИ-агентам — Claude от Anthropic и Codex от OpenAI. Каждый получил собственную копию репозитория и не знал о существовании второго.
После выполнения задания произошло самое интересное. Каждый агент получил работу своего «соперника», должен был найти в ней ошибки, исправить собственные недочёты и при необходимости позаимствовать удачные решения.
Задача была совсем небольшой. Учебный репозиторий содержал Bash-скрипт, который автоматически ищет установленную среду разработки Vivado. После изменения структуры каталогов производителем этот механизм начал работать неправильно. В одном из сценариев скрипт вообще выбирал служебную папку tps вместо установленной версии программы. :chatgpt-content-reference
После нескольких раундов проверки обе модели независимо пришли к одному и тому же результату. Во всех одиннадцати тестовых случаях они выбирали правильный каталог, хотя их решения были написаны совершенно по-разному и не содержали общих фрагментов кода. По мнению Панчула, именно исчезновение расхождений стало главным признаком того, что задача действительно решена.
На первый взгляд речь идёт всего лишь о небольшом Bash-скрипте. Но ценность эксперимента совсем не в размере задачи.
Впервые очень наглядно была показана идея, которая постепенно становится основой современных агентных систем искусственного интеллекта. Конкурируют уже не отдельные модели, а процессы их взаимодействия. Один ИИ создаёт результат, второй ищет ошибки, третий может проверять факты или запускать тесты, а окончательное решение остаётся за человеком.
Именно поэтому сегодня крупнейшие разработчики всё чаще говорят не о «самой умной модели», а об архитектуре работы нескольких специализированных агентов. Для бизнеса это означает важную перемену: конкурентным преимуществом становится уже не выбор одной конкретной нейросети, а правильно организованный процесс её использования.
Но возникает закономерный вопрос. Если второй ИИ способен проверить первого, почему тогда не поручить ему всю работу целиком? Ответ оказался далеко не таким очевидным.
Самое интересное началось после первого раунда. Вместо того чтобы просто сравнить два готовых решения, Панчул заставил каждого агента провести полноценное ревью работы конкурента. Именно здесь проявилось главное преимущество независимой проверки: обе модели заметили ошибки, которые пропустили сами.
Оказалось, что даже решая одну и ту же задачу, Claude и Codex обращали внимание на совершенно разные детали.
Codex обратил внимание на редкий сценарий работы Windows. В некоторых учебных окружениях команда сортировки может оказаться другой программой, которая вообще не умеет сравнивать номера версий.
Claude проверял лишь, что команда завершилась без ошибки, и поэтому выбирал более старую версию Vivado — 2026.9 вместо 2026.10. Codex построил тестовые данные именно для такого случая и обнаружил проблему ещё до запуска скрипта в реальной среде.
Что обнаружил Claude
В свою очередь Claude нашёл недостатки, которые полностью пропустил Codex.
Во время работы Bash-скрипт оставлял после себя служебные переменные окружения. Исходная версия оставляла семь таких переменных, первая версия Claude — одиннадцать, а решение Codex — ни одной. Кроме того, Claude настоял на более понятной диагностике. Если папка пропускалась, пользователь видел объяснение причины, тогда как версия Codex просто переходила к следующему варианту без комментариев.
Во втором раунде оба агента получили замечания друг друга, исправили собственные решения и заимствовали удачные идеи. В результате обе версии начали одинаково проходить все одиннадцать тестов, хотя архитектура и объём кода у них остались разными.
На первый взгляд может показаться, что победила одна из моделей. Но это не так.
Codex написал более компактный код. Claude подготовил более понятную диагностику и лучше объяснил поведение программы. Каждая модель оказалась сильнее в своей области, и ни одна не смогла полностью заменить другую. Выбор окончательной версии всё равно остался за человеком, который оценивал компромисс между лаконичностью, удобством сопровождения и качеством результата.
Именно здесь становится понятна настоящая ценность схемы «два ИИ». Она нужна не для того, чтобы исключить человека из процесса. Наоборот, она помогает предоставить ему два независимых взгляда на одну задачу. Если оба агента приходят к одному выводу — доверие к результату возрастает. Если расходятся — появляется повод разобраться, прежде чем ошибка попадёт в продукт.
Но означает ли один удачный эксперимент, что такую схему стоит применять всегда? Чтобы ответить на этот вопрос, посмотрим на результаты более масштабного научного исследования.
Эксперимент Юрия Панчула показывает, что независимая проверка может быть полезной. Но одного примера недостаточно, чтобы делать общие выводы. Поэтому интересно посмотреть на исследования, где подобную схему проверяли уже на большом количестве задач.
Летом 2026 года исследователи из Калифорнийского университета в Дэвисе, Университета Джонса Хопкинса и Калифорнийского государственного университета в Лонг-Бич опубликовали работу, посвящённую взаимной проверке кода разными языковыми моделями. Важно отметить: это препринт, а не прошедшая полноценное рецензирование научная статья, поэтому относиться к результатам следует осторожно.
Авторы использовали 116 задач средней и высокой сложности из набора LiveCodeBench. Это свежие задачи соревнований по программированию, появившиеся уже после завершения обучения моделей, поэтому они не могли быть просто «выучены наизусть». Сравнивались Claude Opus 4.7 и Codex GPT-5.5.
Для Claude картина оказалась противоположной.
Исследователи подробно разобрали причины этих изменений. Claude сумел исправить 26 ошибочных решений Codex и испортил лишь 5 уже правильных. Codex, наоборот, исправил только 3 ошибки Claude, зато внёс проблемы в 13 корректных решений.
Само наличие второго ИИ ещё ничего не гарантирует.
Если проверяющая модель действительно сильнее автора в конкретной задаче, качество возрастает. Если же она уступает или имеет собственные слабые стороны, дополнительная проверка способна сделать результат даже хуже.
Это очень важный вывод для бизнеса. Многие компании сегодня рассуждают по принципу «добавим ещё одну нейросеть — станет лучше». Исследование показывает, что такой подход не работает. Значение имеет не количество моделей, а их роли, компетенции и организация процесса проверки.
Есть и ещё один фактор, который нельзя игнорировать, — стоимость.
В исследовании схема «Codex пишет, Claude проверяет» почти вдвое увеличила расходы: средняя стоимость решения выросла примерно с 0,19 до 0,44 доллара, а время выполнения задачи — с 38 до 112 секунд. Для одного запроса это почти незаметно, но при тысячах ежедневных операций такие различия превращаются в серьёзную статью расходов.
Именно поэтому вопрос сегодня звучит уже не «какая модель лучшая», а гораздо практичнее: на каких задачах дополнительная проверка действительно окупает свои затраты. Ответ на него каждая компания должна искать на собственных данных, а не только по результатам публичных тестов.
Хотя идея «два ИИ проверяют друг друга» только начинает распространяться, сам принцип независимой автоматической проверки уже давно применяется в разработке программного обеспечения. Практически все успешные внедрения строятся одинаково: ИИ не заменяет человека, а становится ещё одним уровнем контроля.
Важно понимать разницу. Большинство опубликованных корпоративных кейсов описывает использование одного ИИ-ревьюера, а не двух конкурирующих моделей. Тем не менее они хорошо показывают, какой эффект вообще даёт независимая проверка результатов работы.
Во всех этих примерах есть одна общая закономерность. Компании не начинают с полной автоматизации. Сначала запускается пилотный проект, затем измеряются скорость, стоимость и количество найденных ошибок. Только после этого принимается решение о масштабировании.
На самом деле идея независимой проверки применима практически к любой интеллектуальной работе, где используется генеративный ИИ.
Юридические документы. Одна модель составляет договор или дополнительное соглашение, вторая ищет противоречия, двусмысленные формулировки, отсутствующие пункты и потенциальные риски.
Маркетинг. Один ИИ готовит рекламный текст или коммерческое предложение, другой проверяет его на неподтверждённые обещания, логические ошибки, несоответствие законодательству и фирменному стилю компании.
Исследования и аналитика. Первая модель пишет обзор рынка или аналитическую записку, вторая проверяет ссылки, цифры, цитаты и соответствие выводов приведённым данным.
Работа с корпоративными знаниями. Один агент отвечает на вопросы сотрудников, второй проверяет, действительно ли ответ подтверждается внутренней базой знаний, а не построен на предположениях модели.
Во всех этих случаях второй ИИ выполняет роль независимого аудитора. Он не обязательно знает больше, чем первый, но смотрит на задачу с другой точки зрения. Именно это позволяет обнаружить ошибки, которые автор собственного ответа часто не замечает.
Остаётся главный вопрос. Если одна правильно организованная проверка уже способна заметно повысить качество работы, означает ли это, что будущее принадлежит всё более крупным «командам» ИИ? Ответ не так очевиден, как кажется.
Последние два года индустрия искусственного интеллекта была сосредоточена на сравнении моделей. Кто лучше пишет код? Кто точнее отвечает? У кого длиннее контекст? Кто быстрее?
Но постепенно становится понятно, что эти вопросы перестают быть главными.
Современные компании всё чаще выигрывают не потому, что используют самую мощную языковую модель, а потому, что умеют правильно организовать её работу. Один агент ищет информацию, другой анализирует документы, третий пишет текст, четвёртый проверяет факты, пятый запускает тесты, а человек принимает окончательное решение.
Именно так сегодня строятся современные ИИ-агенты и корпоративные AI-платформы. Их ценность определяется уже не отдельной моделью, а качеством всей архитектуры.
Эксперимент Юрия Панчула интересен именно поэтому. Он показывает не способ улучшить Bash-скрипт, а фундаментальный принцип построения агентных систем — независимую проверку результатов. Если несколько моделей приходят к одинаковому выводу независимо друг от друга, доверие к результату существенно возрастает. Если начинают спорить — это сигнал, что задачу ещё нельзя считать решённой.
Исследования не подтверждают распространённый миф о том, что «чем больше нейросетей, тем лучше результат». Всё значительно сложнее.
Второй ИИ способен существенно повысить качество работы, если он действительно выступает независимым проверяющим и обладает достаточной компетенцией. Но он может и ухудшить результат, если слабее автора или просто повторяет его ошибки. Именно поэтому количество моделей само по себе ничего не гарантирует.
Практика показывает другое. Качество определяется процессом: независимой проверкой, обязательными тестами, понятной документацией и человеком, который принимает окончательное решение. Именно эта комбинация позволяет получать более надёжный результат, чем работа любой отдельной модели.
Вероятно, именно таким будет следующий этап развития искусственного интеллекта. Конкуренция постепенно смещается от отдельных моделей к архитектурам взаимодействия между ними. Побеждать будут не те, кто подключит самую дорогую нейросеть, а те, кто сумеет построить эффективную систему из нескольких специализированных агентов, каждый из которых отвечает за свою часть работы.
Напишите, что не сходится в этом материале.
Адрес нужен, чтобы ответить. Другим читателям сообщение не показывается.
Дальше
Агент имеет смысл, если задаче нужны несколько шагов и инструменты. Для одного абзаца это лишняя сложность и лишние ошибки.