За последние несколько лет искусственный интеллект научился писать тексты, создавать изображения, генерировать видео и анализировать документы. Однако все эти достижения объединяет одна особенность: они работают с информацией, а не с физическим миром. Новый класс моделей под названием Vision-Language-Action (VLA) делает следующий шаг — он позволяет искусственному интеллекту не только понимать происходящее, но и управлять действиями реальных машин.
Сегодня VLA-модели находятся на том этапе развития, на котором большие языковые модели были несколько лет назад. Они только начинают выходить из исследовательских лабораторий, но уже привлекают внимание крупнейших технологических компаний. NVIDIA, Google DeepMind, Physical Intelligence, Toyota Research Institute и другие участники рынка рассматривают их как основу будущего поколения автономных роботов.
Что такое Vision-Language-Action
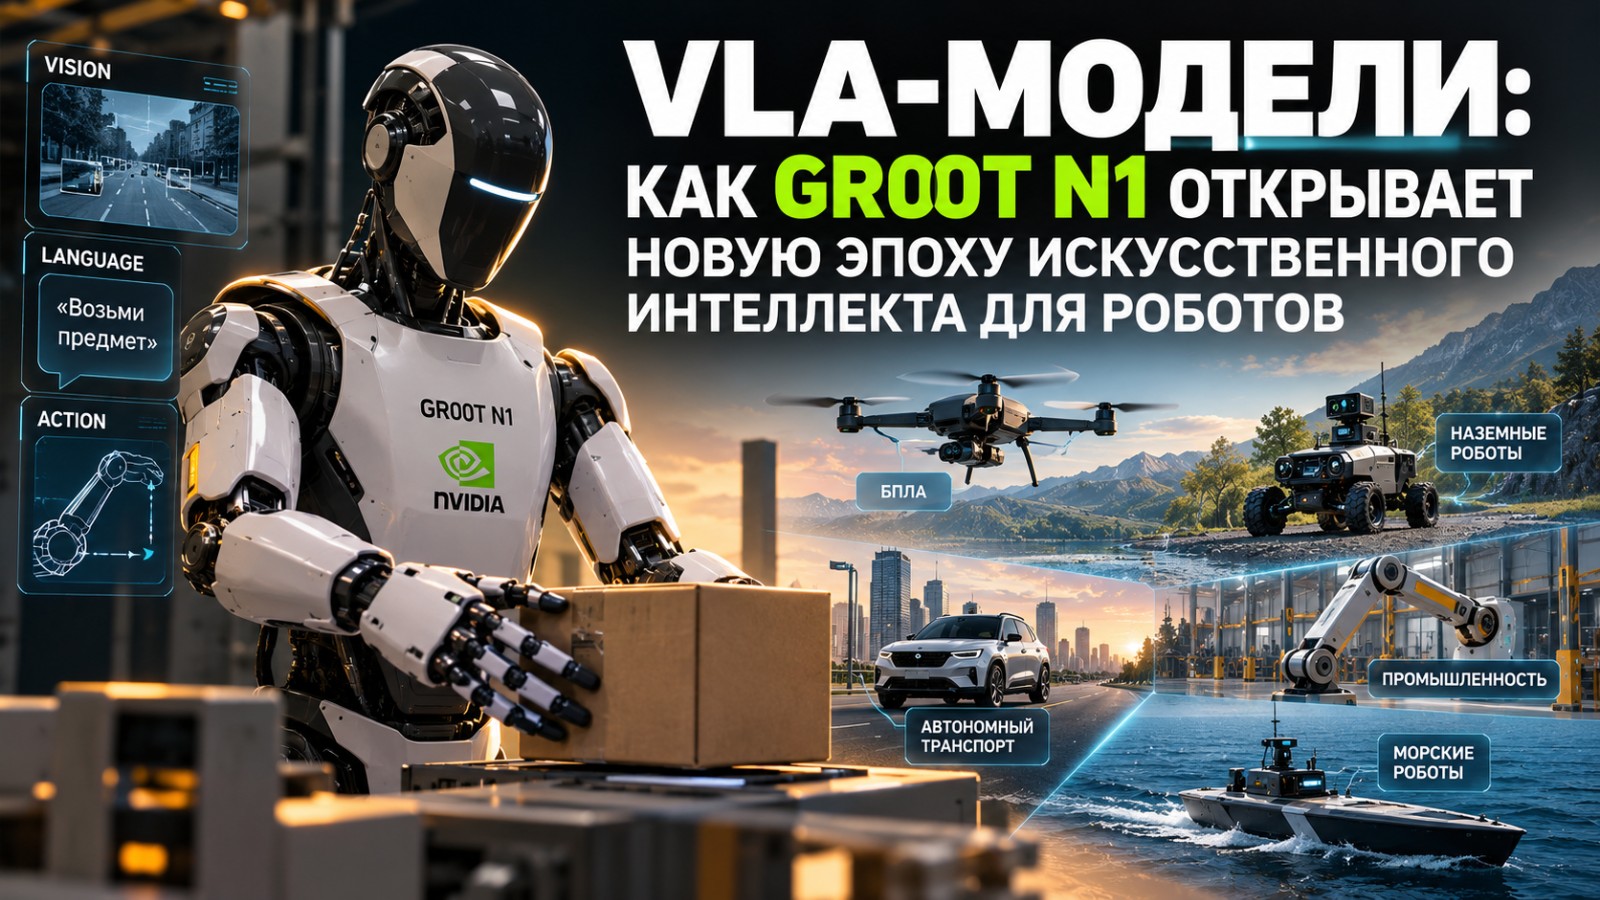
Название Vision-Language-Action отражает три типа данных, с которыми работает модель.
Vision — зрительная информация. Это изображения с камер, глубинных сенсоров, тепловизоров или других средств восприятия окружающей среды.
Language — естественный язык. Машина получает задачу в привычной человеку форме: «возьми коробку», «открой дверь», «найди инструмент» или «перемести объект на полку».
Action — пространство действий. Вместо текста модель формирует последовательность команд, которые приводят машину в движение.
Именно компонент Action делает VLA-модели принципиально новым этапом развития искусственного интеллекта. Их результатом становится не ответ пользователю, а физическое действие.
Почему появился новый класс моделей
Создать подобные системы пытались и раньше, однако долгое время каждая задача требовала отдельного алгоритма. Робота обучали брать предмет, открывать дверь или переносить коробку как независимым навыкам. Если менялась задача, обучение приходилось начинать практически заново.
VLA-модели используют другой подход. Вместо большого количества специализированных алгоритмов создается единая foundation-модель, которая обучается на огромном массиве разнообразных действий. Благодаря этому она начинает не просто повторять увиденные движения, а переносить полученный опыт на новые ситуации.
Например, если модель научилась брать кружку со стола, она может применить похожую стратегию для бутылки, коробки или другого объекта, которого раньше никогда не встречала. Это называется обобщением навыков — одной из ключевых целей современной робототехники.
Появление VLA стало возможным не из-за одной технологической идеи, а благодаря совпадению сразу нескольких факторов. Развитие мультимодальных моделей позволило лучше понимать окружающий мир, современные графические процессоры обеспечили необходимую вычислительную мощность, а цифровые двойники и симуляторы сделали возможным обучение миллионов действий без использования реальных роботов.
Action Space — понятие, которое меняет взгляд на управление машинами
Одним из важнейших терминов, связанных с VLA, является Action Space — пространство действий. Именно оно определяет, какими исполнительными механизмами способна управлять модель.
У человекоподобного робота пространство действий включает десятки степеней свободы: положение рук, локтей, кистей, пальцев, корпуса, головы и ног. Модель должна непрерывно рассчитывать движение каждого из этих элементов, сохраняя равновесие и выполняя поставленную задачу.
У промышленного манипулятора пространство действий будет совершенно другим. Вместо человеческих конечностей — несколько шарниров, линейные приводы и захват. Однако принцип работы модели остается тем же: она получает информацию об окружающей среде и преобразует ее в последовательность управляющих команд.
Именно поэтому специалисты все чаще рассматривают VLA не как технологию исключительно для гуманоидов, а как универсальный подход к управлению физическими системами. Меняется не логика модели, а набор исполнительных механизмов, которыми она должна управлять.
Эта идея стала фундаментом для появления одной из самых обсуждаемых моделей нового поколения — NVIDIA GR00T N1, которая впервые продемонстрировала возможности foundation-модели, специально созданной для физических действий, а не только для обработки информации.
NVIDIA GR00T N1 — первая foundation-модель нового поколения
В марте 2025 года NVIDIA представила GR00T N1 — открытую Vision-Language-Action-модель для человекоподобных роботов. Сам по себе гуманоид не был новостью: подобные проекты уже существуют у Figure AI, Agility Robotics, 1X, Boston Dynamics и других компаний. Значение GR00T N1 заключается в другом — впервые одна foundation-модель была создана не для генерации информации, а для выполнения широкого спектра физических действий.
Вместо разработки отдельного программного обеспечения для каждой операции NVIDIA предложила универсальную модель, которую можно адаптировать под различные конструкции роботов и новые задачи. Такой подход напоминает переход от узкоспециализированных языковых моделей к современным универсальным LLM, только теперь речь идет не о тексте, а о действиях.
Две системы вместо одной
Одной из наиболее интересных особенностей GR00T N1 стала архитектура, разделяющая процесс принятия решения на две взаимосвязанные системы.
System 2 отвечает за анализ ситуации и планирование. Она использует мультимодальную модель, которая воспринимает изображения с камер, текстовые инструкции и информацию о состоянии робота. На этом этапе формируется понимание происходящего: какой объект находится перед роботом, что именно требуется сделать и какие действия приведут к нужному результату.
System 1 получает уже готовый план и преобразует его в непрерывную последовательность движений. Для этого NVIDIA использует диффузионную модель (Diffusion Transformer), способную генерировать плавные траектории движения рук, корпуса и пальцев с учетом физических ограничений робота.
Подобное разделение напоминает концепцию двух систем мышления человека, предложенную психологом Даниэлем Канеманом: одна отвечает за осознанное планирование, другая — за быстрое выполнение привычных действий. Хотя аналогия условна, она хорошо объясняет принцип работы GR00T N1.
Как обучают такую модель
Главная проблема робототехники заключается в том, что обучение на реальных машинах обходится дорого и занимает много времени. Каждый эксперимент требует оборудования, контроля безопасности и большого количества повторений. Поэтому NVIDIA сделала ставку на комбинированный подход.
Во время обучения используются реальные записи движений роботов, видеодемонстрации действий человека, синтетические данные, созданные в цифровых двойниках NVIDIA Omniverse, а также искусственно сгенерированные сценарии. Это позволяет сформировать огромный набор разнообразных примеров без необходимости выполнять каждое действие на физическом устройстве.
После предварительного обучения модель можно адаптировать под конкретного робота. Вместо создания системы управления с нуля разработчики дообучают уже готовую foundation-модель, существенно сокращая время разработки.
Почему NVIDIA открыла GR00T N1
Вместе с моделью компания опубликовала инструменты для обучения, наборы данных и программные компоненты, необходимые исследователям и разработчикам. Такой шаг показывает, что NVIDIA рассматривает GR00T N1 не как продукт для одного конкретного робота, а как основу будущей экосистемы Physical AI.
Чем больше компаний будут использовать единую архитектуру, тем быстрее будет накапливаться опыт, появятся новые датасеты, методы обучения и специализированные версии моделей. Подобный эффект уже наблюдался в области больших языковых моделей, где открытые проекты значительно ускорили развитие всей отрасли.
Именно поэтому значение GR00T N1 определяется не количеством параметров и не вычислительной мощностью. Гораздо важнее то, что эта модель показала: foundation-модель может стать универсальным уровнем управления физическими действиями, поверх которого будут строиться роботы самых разных типов.
После гуманоидов — другие машины?
Хотя сегодня VLA-модели в первую очередь ассоциируются с человекоподобными роботами, сама архитектура не ограничивается этим классом устройств. Основная идея заключается в том, что модель воспринимает окружающую среду, понимает поставленную задачу и формирует последовательность управляющих действий. Какие именно исполнительные механизмы будут выполнять эти команды, зависит уже от конкретной машины.
Например, у промышленного манипулятора действиями являются повороты шарниров и работа захвата. У мобильного робота — скорость движения и направление колес. У автономного автомобиля — рулевое управление, ускорение и торможение. Во всех случаях меняется пространство действий, но общий принцип работы VLA остается неизменным.
По этой причине многие исследователи рассматривают Vision-Language-Action как универсальную архитектуру для будущих автономных систем, а не как технологию исключительно для гуманоидных роботов.
Могут ли VLA-модели использоваться в беспилотной авиации?
На момент публикации NVIDIA не заявляла о создании версии GR00T N1 для управления беспилотными летательными аппаратами. Модель разрабатывалась для гуманоидных роботов и обучалась на соответствующих данных.
Однако сама концепция VLA хорошо сочетается с архитектурой современных автономных БПЛА. Теоретически такая модель могла бы получать данные с камер, тепловизоров, инерциальной навигации, барометра, лидаров или других сенсоров, понимать поставленную оператором задачу и формировать команды для системы управления полетом.
При этом важно понимать, что низкоуровневая стабилизация дрона — управление тягой двигателей, компенсация порывов ветра и поддержание устойчивости — остается задачей специализированного автопилота. Именно поэтому наиболее реалистичным сценарием сегодня выглядит совместная работа VLA-модели и классических систем управления, а не их взаимная замена.
От роботов к Physical AI
В своих последних анонсах NVIDIA все чаще использует термин Physical AI — «физический искусственный интеллект». Под этим понимается создание моделей, способных взаимодействовать с реальным миром так же естественно, как современные языковые модели взаимодействуют с информацией.
Для развития Physical AI недостаточно одной модели. Необходимы цифровые двойники, инструменты моделирования, синтетические данные, вычислительная инфраструктура и аппаратные платформы. Именно поэтому NVIDIA развивает целую экосистему, в которую входят Omniverse, Isaac Sim, Isaac Lab, Cosmos и GR00T. Вместе они образуют полный цикл — от генерации обучающих данных до работы готового робота.
Пока Vision-Language-Action находится в начале своего пути, и многие технические проблемы еще предстоит решить: повысить надежность моделей, сократить задержки принятия решений, уменьшить требования к вычислительным ресурсам и научить системы безопасно работать в непредсказуемой среде. Тем не менее направление развития уже определилось.
Вывод
GR00T N1 интересен не только как очередная разработка NVIDIA. Гораздо важнее то, что эта модель стала одним из первых публичных примеров нового класса foundation-моделей, ориентированных на выполнение физических действий. Если большие языковые модели изменили способы работы с информацией, то Vision-Language-Action может изменить способы взаимодействия машин с окружающим миром.
В ближайшие годы мы, вероятно, увидим специализированные VLA-модели для промышленных роботов, автономного транспорта, мобильных платформ и других видов техники. Поэтому появление GR00T N1 можно рассматривать не как завершенный продукт, а как начало нового этапа развития искусственного интеллекта — этапа, в котором ИИ будет не только понимать мир, но и действовать в нем.
Источники
- NVIDIA Developer Blog. Accelerate Generalist Humanoid Robot Development with NVIDIA Isaac GR00T N1.
- NVIDIA Newsroom. NVIDIA Launches Isaac GR00T N1 Open Humanoid Robot Foundation Model.
- Research paper: NVIDIA Isaac GR00T N1: An Open Foundation Model for Generalist Humanoid Robots. arXiv.
- GitHub: NVIDIA Isaac GR00T — официальный репозиторий проекта.
- NVIDIA Isaac Lab Documentation.
- NVIDIA Isaac Sim Documentation.