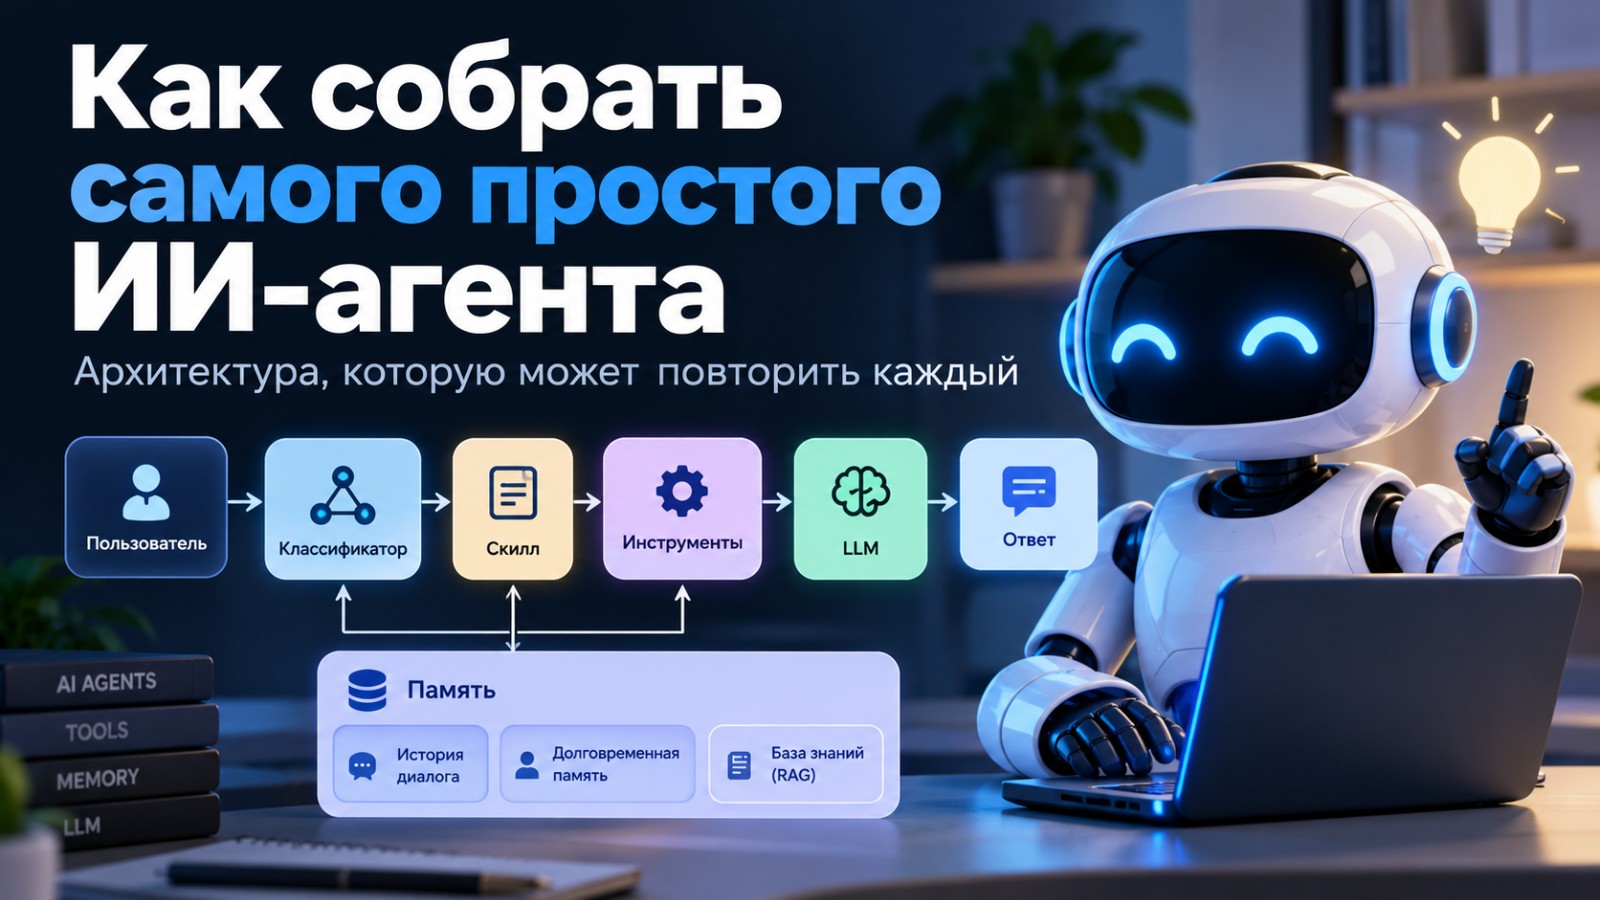
Когда говорят об ИИ-агентах, часто создается впечатление, что это какая-то сложная технология с множеством моделей и компонентов. На практике минимальный агент состоит всего из четырех основных частей: классификатора, набора скиллов, инструментов и языковой модели (LLM). Этого уже достаточно, чтобы агент понимал запросы пользователя, выполнял необходимые действия и формировал ответ.
Важно понимать разницу между обычным чат-ботом и агентом. Чат-бот получает запрос и сразу передает его языковой модели. Модель анализирует текст и генерирует ответ. Если информации недостаточно, она может начать ошибаться или придумывать факты. Агент работает иначе: сначала он определяет, что нужно сделать, затем выполняет необходимые действия с помощью инструментов, и только после этого формирует ответ.
Пользователь
      │
      ▼
Классификатор
      │
      ▼
    Skill
      │
      ▼
    Tools
      │
      ▼
      LLM
      │
      ▼
 Пользователь
Рассмотрим каждый компонент подробнее.
Классификатор
Первая задача агента — определить, какой сценарий выполнения подходит для текущего запроса. Для этого используется классификатор. Это может быть отдельная модель, небольшая LLM или даже набор правил.
Например, пользователь пишет:
- «Какая сегодня погода?»
- «Напиши краткое содержание статьи.»
- «Создай изображение космического корабля.»
Хотя все запросы написаны естественным языком, для их выполнения требуются совершенно разные действия. Задача классификатора — выбрать правильный скилл.
Skill
Скилл (Skill) — это описание того, как выполнить конкретную задачу. Он не содержит сложной логики искусственного интеллекта. Его задача — определить последовательность действий и необходимые инструменты.
Например, скилл «Поиск новостей» может состоять из следующих шагов:
- Выполнить поиск.
- Получить содержимое найденных страниц.
- Выделить главное.
- Передать результаты языковой модели.
Каждый скилл отвечает только за одну задачу. Такой подход упрощает разработку, тестирование и дальнейшее расширение агента.
Tools
Инструменты (Tools) выполняют реальные действия. Они не принимают решений и не анализируют смысл запроса. Каждый инструмент выполняет только одну функцию.
Типичные инструменты:
- поиск в интернете;
- HTTP API;
- работа с базой данных;
- RAG-поиск по документам;
- генерация изображений;
- запуск Python-кода;
- отправка сообщений в Telegram или по электронной почте.
Скилл управляет инструментами, определяя, какой из них вызвать и в какой последовательности.
LLM
После выполнения всех необходимых действий результаты передаются языковой модели. Именно здесь происходит анализ полученных данных и формируется ответ, который увидит пользователь.
Важно отметить, что LLM не обязана самостоятельно искать информацию или выполнять действия. Если необходимые данные уже собраны инструментами, задача модели значительно упрощается: она получает готовые результаты, анализирует их и преобразует в понятный человеку текст.
В следующей части мы разберем полный цикл обработки запроса и проследим путь от сообщения пользователя до готового ответа, чтобы увидеть, как все компоненты работают вместе.
Теперь рассмотрим, как все компоненты взаимодействуют между собой на примере реального запроса.
Предположим, пользователь пишет:
«Какая погода будет завтра в Москве?»
Агент не отправляет этот запрос сразу в языковую модель. Вместо этого он проходит несколько этапов обработки.
Пользователь
      │
      ▼
Классификатор
      │
      ▼
 Skill «Погода»
      │
      ▼
 Weather API
      │
      ▼
      LLM
      │
      ▼
 Ответ пользователю
Шаг 1. Выбор скилла
Классификатор анализирует запрос и определяет, что пользователь хочет получить прогноз погоды. Для этого подходит скилл «Погода».
Если бы запрос был «Переведи текст на английский», был бы выбран другой скилл. Если пользователь попросил найти новости — третий. Классификатор занимается только выбором подходящего сценария и не выполняет никаких действий самостоятельно.
Шаг 2. Выполнение скилла
После выбора начинается выполнение скилла.
Например, внутри скилла «Погода» могут быть описаны следующие действия:
- Определить город.
- Определить дату прогноза.
- Вызвать API погодного сервиса.
- Получить прогноз.
Скилл не знает, как работает погодный сервис. Он лишь вызывает соответствующий инструмент и получает результат.
Шаг 3. Работа инструментов
Инструмент обращается к внешнему сервису и возвращает данные. Обычно это обычный JSON-документ.
Например:
{
  "city": "Москва",
  "temperature": 14,
  "condition": "Облачно",
  "wind": 5
}
На этом этапе никакого красивого текста еще нет. Получены только структурированные данные.
Шаг 4. Работа LLM
Теперь результат передается языковой модели.
LLM получает уже готовые данные и формирует понятный человеку ответ, например:
«Завтра в Москве ожидается облачная погода. Температура воздуха около +14 °C, ветер до 5 м/с.»
Обратите внимание: модель не искала погоду самостоятельно и не пыталась угадать прогноз. Она использовала информацию, которую уже получил инструмент.
Почему это важно
Разделение обязанностей делает агента более надежным.
- Классификатор выбирает нужный сценарий.
- Скилл определяет последовательность действий.
- Инструменты получают реальные данные.
- LLM анализирует результаты и формирует ответ.
Такой подход легко масштабируется. Чтобы добавить новую возможность, обычно достаточно создать новый скилл и подключить необходимые инструменты. Остальная архитектура агента остается без изменений.
В следующей части мы добавим еще один важный компонент — память, благодаря которой агент сможет учитывать предыдущие сообщения, предпочтения пользователя и использовать собственную базу знаний.
До этого момента агент обрабатывал каждый запрос так, словно видел пользователя впервые. На практике этого недостаточно. Чтобы вести связный диалог, помнить предпочтения пользователя и работать с собственной документацией, агенту нужна память.
Важно понимать, что память — это не один объект. Обычно она состоит из нескольких независимых компонентов, каждый из которых решает свою задачу.
Memory
 ├── История диалога
 ├── Долговременная память
 └── База знаний (RAG)
История диалога
Самый простой вид памяти — история текущего разговора. Благодаря ей агент понимает, к чему относятся местоимения и уточнения.
Например:
Пользователь: «Расскажи про ChatGPT.»
Пользователь: «А сколько у него контекст?»
Без истории диалога второй вопрос становится непонятным. Агент не знает, о чем идет речь. История позволяет сохранить контекст разговора и передать его языковой модели.
Долговременная память
Этот тип памяти хранит информацию, которая может пригодиться в будущих диалогах.
Например:
- предпочитаемый язык общения;
- имя пользователя;
- активный проект;
- любимый формат ответов;
- индивидуальные настройки.
Такие данные не нужно спрашивать при каждом новом запросе. Агент может автоматически использовать их при выполнении соответствующих скиллов.
База знаний (RAG)
RAG (Retrieval-Augmented Generation) — это память другого типа. Она хранит не информацию о пользователе, а документы, инструкции, статьи, внутреннюю документацию компании и другие источники знаний.
Когда пользователь задает вопрос, агент может выполнить поиск по этой базе и получить только те фрагменты документов, которые относятся к запросу.
После этого найденные материалы передаются языковой модели, которая формирует итоговый ответ.
Когда агент использует память
Память может использоваться на разных этапах выполнения запроса.
Пользователь
      │
      ▼
Чтение Memory
      │
      ▼
Классификатор
      │
      ▼
    Skill
      │
 ┌────┴─────────────┐
 │                  │
 ▼                  ▼
Tools            Memory
 │
 ▼
      LLM
      │
      ▼
Запись новой информации
      │
      ▼
 Пользователь
Перед выбором скилла агент может прочитать настройки пользователя. Во время выполнения скилла — обратиться к базе знаний или сохранить промежуточные данные. После формирования ответа — записать новую информацию в долговременную память, если она может пригодиться в будущем.
Нужно ли всегда использовать память?
Нет. Если пользователь задает простой вопрос, например «Сколько будет 125 × 16?», память не требуется. Но если задача связана с предыдущими сообщениями, персональными настройками или внутренними документами, память становится важной частью архитектуры.
В следующей части мы объединим все компоненты в единую схему, рассмотрим полный цикл работы агента и разберем практические рекомендации по проектированию собственной агентной системы.
Теперь объединим все рассмотренные компоненты в единую архитектуру. Именно так устроено большинство современных ИИ-агентов независимо от используемой платформы или языковой модели.
                 Пользователь
                       │
                       ▼
             Классификатор
                       │
                       ▼
                   Skill
            ┌────────┼────────┐
            ▼        ▼        ▼
         Memory    Tools     RAG
            │        │
            └────┬───┘
                 ▼
                LLM
                 │
                 ▼
          Ответ пользователю
Обработка каждого запроса происходит по одному и тому же принципу.
- Пользователь отправляет запрос.
- Классификатор определяет, какой скилл необходимо выполнить.
- Скилл читает память, если это необходимо.
- Скилл вызывает один или несколько инструментов.
- Инструменты получают реальные данные или выполняют действия.
- При необходимости выполняется поиск по базе знаний (RAG).
- Все полученные результаты передаются языковой модели.
- LLM анализирует информацию и формирует итоговый ответ.
- Если появились новые важные данные, они сохраняются в память.
Как проектировать скиллы
Распространенная ошибка — создавать один большой универсальный скилл, который пытается решить все возможные задачи. Такой подход быстро приводит к усложнению кода и затрудняет поддержку.
Лучше придерживаться простого правила:
- один скилл — одна задача;
- один инструмент — одно действие;
- каждый компонент должен иметь только одну область ответственности.
Например, вместо одного скилла «Работа с документами» лучше создать несколько независимых:
- «Поиск документа»;
- «Извлечение текста»;
- «Резюмирование»;
- «Перевод»;
- «Проверка фактов».
Такую архитектуру значительно проще тестировать, расширять и повторно использовать в других агентах.
Минимальный набор инструментов
Для большинства проектов достаточно нескольких базовых инструментов:
- поиск в интернете;
- HTTP/API-клиент;
- RAG-поиск по документам;
- работа с файлами;
- доступ к базе данных;
- выполнение Python-кода.
Остальные инструменты можно добавлять по мере необходимости.
Итоги
Самый простой ИИ-агент не требует сложной инфраструктуры. Его можно построить всего из нескольких независимых компонентов:
- классификатор выбирает нужный скилл;
- скилл определяет последовательность действий;
- инструменты выполняют работу;
- память хранит контекст и знания;
- LLM анализирует результаты и формирует ответ.
Такое разделение делает архитектуру модульной. Чтобы добавить новую возможность, обычно не требуется изменять весь агент — достаточно создать новый скилл, подключить необходимые инструменты и зарегистрировать его в классификаторе. Именно поэтому современные агентные системы легко масштабируются: количество навыков может расти без существенного усложнения основной логики работы.