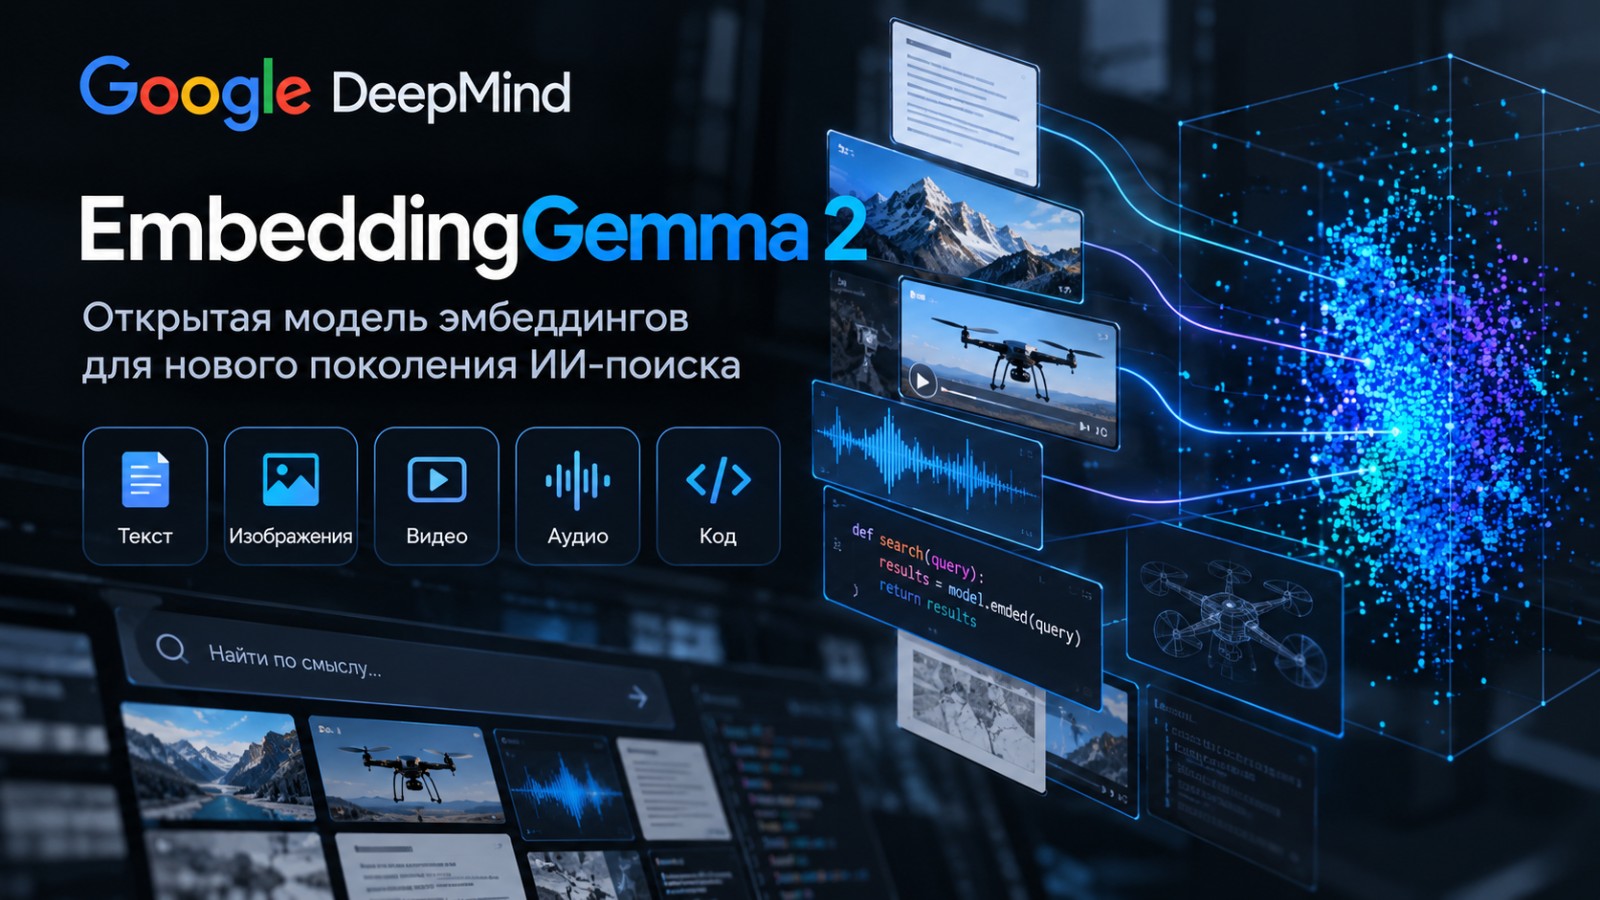
Google продолжает расширять семейство открытых моделей Gemma и представила EmbeddingGemma 2 — новую модель эмбеддингов, предназначенную для создания современных систем семантического поиска, RAG-платформ, корпоративных баз знаний и ИИ-агентов.
В отличие от больших языковых моделей, EmbeddingGemma 2 не генерирует текст. Ее задача — преобразовывать информацию в векторные представления (эмбеддинги), позволяющие компьютеру понимать смысл запросов и документов. Именно такие представления лежат в основе интеллектуального поиска, рекомендаций и большинства современных RAG-систем.
По данным Google, модель оптимизирована для получения высококачественных текстовых эмбеддингов и ориентирована на задачи поиска, извлечения информации, кластеризации, классификации и ранжирования документов. Она распространяется как открытая модель семейства Gemma и может использоваться как в облачной инфраструктуре, так и локально.
Для разработчиков ИИ это особенно важный релиз. Качество эмбеддингов напрямую влияет на эффективность поиска: если система не смогла найти нужный документ, даже самая мощная языковая модель не сможет дать точный ответ. Поэтому развитие моделей эмбеддингов является одним из ключевых направлений в построении современных ИИ-приложений.
Google отмечает, что EmbeddingGemma 2 создана для широкого круга сценариев — от корпоративных баз знаний и поиска по документации до интеллектуальных помощников, агентных систем и других приложений, где требуется понимать смысл текста, а не просто совпадение слов.