Введение: проблема, которую решает «Гига Писарь»
Мы по‑прежнему печатаем письма, заметки и рабочие сообщения вручную, хотя продиктовать тот же текст обычно в несколько раз быстрее. Мешает не лень, а риск и неудобство: большинство популярных сервисов голосового ввода отправляют вашу запись на удалённые серверы. Для личной переписки это терпимо, для договоров, кадровых документов и коммерческих переговоров — рискованно. «Гига Писарь» предлагает альтернативу: распознавание речи прямо на устройстве. Разбираемся, что это за инструмент, кому он полезен и какие вопросы остаются открытыми.
Кратко: зачем читать эту статью
Если вы руководитель, предприниматель или специалист, который работает с чувствительными данными, вам важно понять, какие преимущества даёт локальная диктовка и какие ограничения у текущих решений. Мы объясним, как устроен «Гига Писарь», на чём он основан, приведём ориентировочное сравнение с альтернативами и предложим практический план теста.
Что умеет
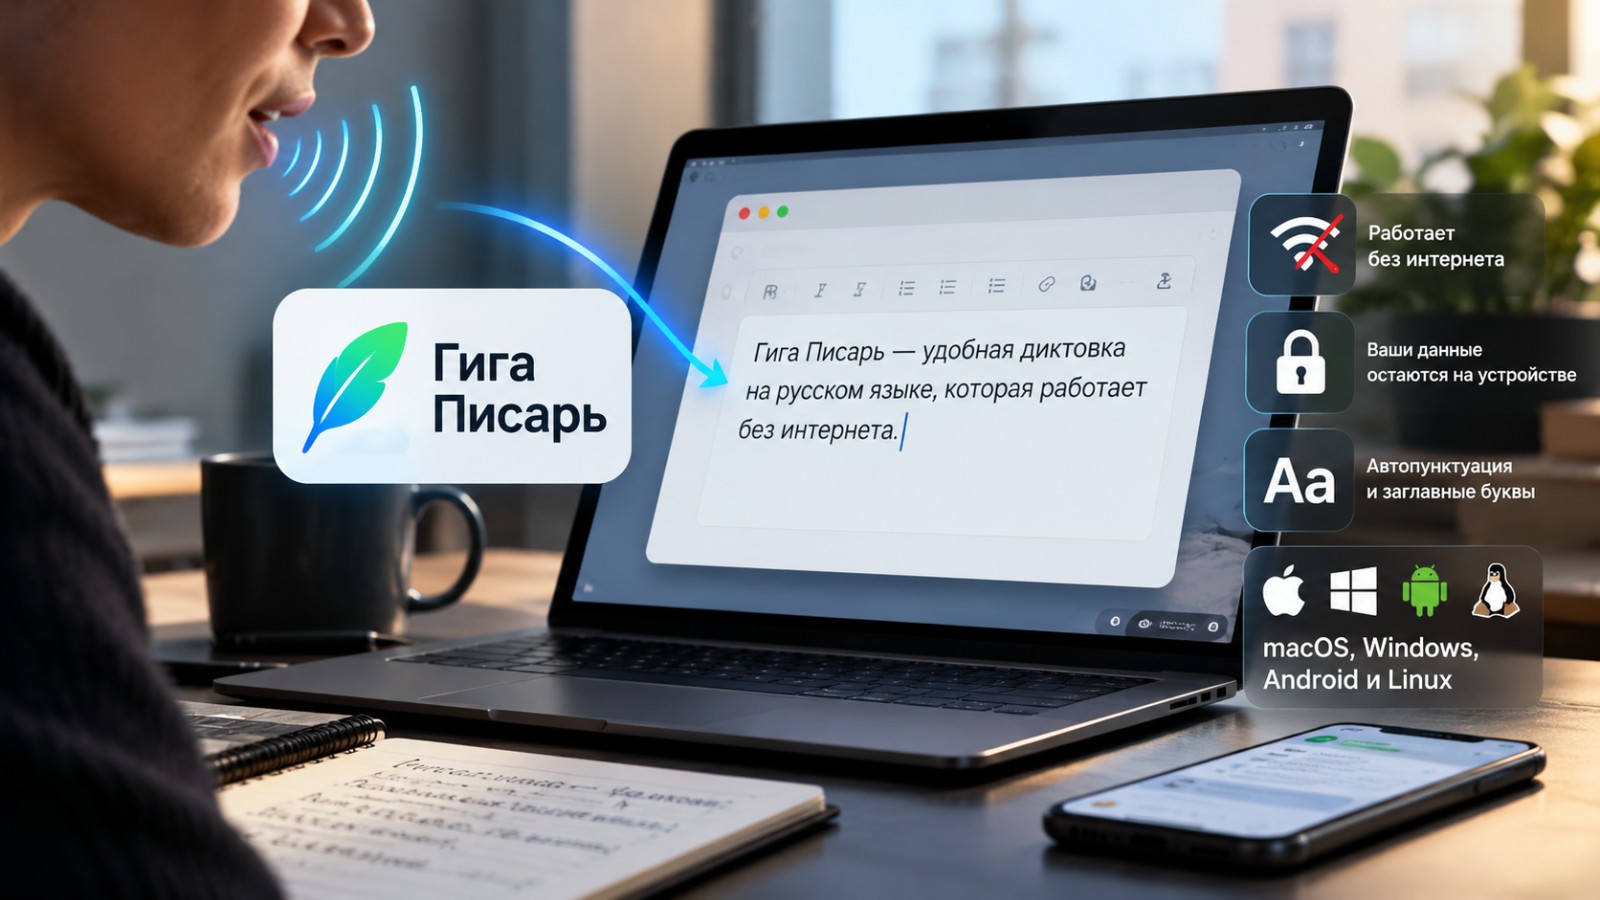
- Платформы: macOS, Windows, Android; есть консольная версия (CLI); в публикациях упоминается и Linux.
- Офлайн‑работа: распознавание выполняется на устройстве, звук не уходит в сторонние облака (при стандартных настройках).
- Язык: основной фокус — русский язык.
- Автопунктуация: модель расставляет запятые, точки и заглавные буквы, диктовать знаки препинания не нужно.
- Английские вставки: по описанию авторов, приложение корректно обрабатывает англицизмы внутри русской речи.
- Интерфейс: push‑to‑talk — зажали клавишу, говорите, отпустили — текст вставился в то место, где стоит курсор.
- Лицензия и цена: проект open‑source, бесплатно; исходники доступны в общедоступных репозиториях.
Как это работает
«Гига Писарь» — не облачный чат‑бот и не сервис с платными минутами: это утилита, которая запускает модель распознавания речи локально. В типичном сценарии вы находитесь в приложении (почта, мессенджер, редактор) и, зажав горячую клавишу, диктуете фразу — по отпусканию клавиши текст вставляется туда, где был курсор. Такой подход минимизирует переключения и ускоряет рабочий поток.
По описанию проекта, горячие клавиши зависят от платформы: правый ⌘ на macOS, правый Ctrl на Windows и клавиша уменьшения громкости на Android. На мобильных устройствах текст либо вставляется в активное поле, либо копируется в буфер обмена.
Что под капотом: модель GigaAM v3
За распознаванием стоит модель GigaAM v3, которую обучал Сбер с акцентом на русскоязычные данные. Авторы проекта используют эти веса и интегрируют их в приложение так, чтобы распознавание выполнялось локально на машине пользователя. По описаниям, есть версии, которые работают и без GPU — на CPU.
Важно: публичные описания не всегда содержат проверяемые цифры о размере модели, реальных требованиях к памяти и скорости на слабых ноутбуках. Эти параметры стоит тестировать на своих устройствах перед массовым развёртыванием.
Сравнение с альтернативами
| Параметр | Гига Писарь | Google (облачные сервисы) | Whisper (OpenAI) |
| Нужен интернет | Нет (офлайн) | Да (облако) | Зависит от сборки |
| Работа локально | Да | Нет | Да, при локальной сборке |
| Русский язык | Оптимизировано | Поддерживается | Многоязычная модель |
| Бесплатно | Да | Частично (платные API) | Модель доступна |
Примечание. Таблица ориентировочная и составлена на основе публичных описаний. Утверждение авторов «Гига Писаря» о превосходстве GigaAM над Whisper на русском — их позиция; независимых, сопоставимых замеров на общих данных в открытом доступе мы не обнаружили.
Почему офлайн важен для бизнеса
Облачные транскрипторы удобны, но отправка аудио на внешние сервера создаёт организационные и юридические риски: кто хранит запись, где она хранится и на каких условиях, как устроена ретенция данных. Локальная обработка снижает эти риски: звук остаётся на устройстве, нет дополнительной платы за минуты распознавания и меньше зависимости от внешних операторов.
Однако «локально» не исключает рисков полностью: распознанный текст попадает в приложения (почта, CRM, облачные трекеры), которые могут синхронизироваться. Кроме того, в репозитории и блогах проекта упоминается опциональная интеграция «со своим ключом в облаке» — её поведение и объём отправляемых данных следует изучить отдельно.
Где это пригодится — практические сценарии
- Руководителям: быстрые поручения и заметки после встречи — диктовка сокращает время на набор и формулировку.
- Предпринимателям: черновики коммерческих предложений, ответы клиентам — автопунктуация уменьшает количество правок.
- Юристам и кадровикам: при работе с чувствительной информацией локальная обработка снижает риск утечек (окончательное решение принимает служба безопасности компании).
- Новичкам в ИИ: диктовка — простой и заметный эффект от технологий без необходимости работать с промптами или платить за подписки.
Ограничения и открытые вопросы
- Точность на конкретных данных. Заявления о превосходстве над Whisper — мнение авторов проекта; независимых сравнений на одинаковых данных мы не нашли.
- Системные требования. Объём памяти, комфортная скорость на старых машинах и энергопотребление на мобильных устройствах требуют проверки в реальных условиях.
- Облачные опции. Какие данные отправляются при использовании «ключа в облаке», как это включается и для каких функций — нужно проверить документацию.
- Поддержка и SLA. Проект сообщественный: нет корпоративных гарантий, служебной поддержки или формальных соглашений об уровне сервиса.
- Авторство и прозрачность. В публичных источниках имя автора в блогах (ladapriora) соседствует с репозиториями на другом аккаунте (moznoazachem); уровни участия и организаторская структура проекта не полностью задокументированы.
- Многоязычность. Решение ориентировано на русский язык; для многоязычных команд потребуются дополнительные инструменты.
Как проверить «Гига Писарь» в компании — пошаговый пилот
- Установите приложение на одну рабочую станцию и на смартфон тестировщика (не разворачивайте сразу на весь парк).
- Продиктуйте 10–15 реальных рабочих текстов: письмо, поручение, примечание к задаче. Сравните время набора и количество правок с привычным вводом.
- Протестируйте в шумной обстановке и с отраслевой терминологией — именно там чаще всего появляются скрытые ошибки.
- Уточните у службы IT‑безопасности, какие функции приложения могут обращаться в сеть и допустимо ли их использование для ваших данных.
- На основе пилота примите решение о масштабе внедрения и правилах использования.
Почему это важно для российского AI
Проект «Гига Писарь» иллюстрирует несколько значимых трендов в экосистеме локальных ИИ‑решений. Во‑первых, крупные компании (в данном случае Сбер) создают и открывают модели, обученные на национальных данных; во‑вторых, независимые команды и энтузиасты быстро превращают эти веса в прикладные инструменты, закрывая практические ниши.
Для бизнеса это означает рост доступных опций: можно получить конкурентное качество для русского языка без отправки данных за рубеж. Для индустрии в целом это — сигнал, что практичные локальные приложения перестают быть экспериментом и выступают как фактор технологической автономии. При этом полная независимость остаётся иллюзорной: приложения работают на macOS, Windows и Android — платформах с глобальной инфраструктурой.
Итог
«Гига Писарь» — это прагматичный шаг к повседневному использованию ИИ. Он не претендует на роль масштабной корпоративной платформы с SLA, но решает очевидную задачу: быстро и локально перевести речь в текст. Сильные стороны — приватность и бесплатность; слабые стороны — отсутствие независимых сравнений качества и формальной корпоративной поддержки.
Рекомендация для компаний: начать с короткого пилота — это дешевле и информативнее, чем гипотетические дискуссии о «лучшести» моделей. Тестируйте на своих типовых данных и примите решение на основании практического результата.
Источники и статус данных
- Официальная страница проекта: gigapisar.github.io — описание и ссылки на репозитории.
- Репозитории на GitHub (moznoazachem): giga-pisar, giga-pisar-win, giga-pisar-android, giga-pisar-cli; зеркала на GitFlic.
- Корпоративный блог проекта на «Хабре» — публикации авторов о релизах и работе сообщества.
- Обзоры и заметки в профильных изданиях (apptractor.ru, braintools.ru) — вторичные источники.
Данные собраны из открытых источников. Мы не проводили собственных лабораторных замеров производительности и качества распознавания; в тексте прямо отмечены пункты, требующие проверки перед внедрением.